Werner Vogels, od ponad dwóch dekad CTO Amazona i jeden z ludzi stojących za technicznymi fundamentami AWS, nie obiecuje bezbłędnej sztucznej inteligencji. W rozmowie ze Spider’s Web mówi o czymś znacznie mniej efektownym, za to ważniejszym: o kontroli, odpowiedzialności, kosztach i odzyskiwaniu zaufania w epoce, w której obraz, głos, opinia klienta, a choćby decyzja programu przestały być dowodem czegokolwiek.
W branży nowych technologii nie brakuje ludzi, którzy przepowiadają przyszłość. Zwykle robią to na scenie, przy efektownej prezentacji i z wykresem zmierzającym obowiązkowo w prawy górny róg. Werner Vogels należy jednak do innej kategorii. To nie komentator obserwujący chmurę obliczeniową z zewnątrz, ale jeden z architektów epoki, w której infrastruktura informatyczna przestała być kupowanym raz na kilka lat zestawem serwerów, a stała się usługą uruchamianą na żądanie.
Vogels dołączył do Amazona we wrześniu 2004 r. jako dyrektor ds. badań nad systemami, a w styczniu 2005 r. został dyrektorem technicznym firmy. Wcześniej przez dekadę pracował naukowo na Cornell University nad skalowalnymi i odpornymi systemami rozproszonymi; ma doktorat z informatyki Vrije Universiteit Amsterdam. Amazon opisuje go jako jednego ze światowych ekspertów od systemów rozproszonych i człowieka, który odegrał istotną rolę w budowie infrastruktury firmy oraz narodzinach AWS.
To ważne rozróżnienie. Vogels nie jest CTO od pokazywania nowego koloru obudowy czy dopisywania „AI” do istniejącej aplikacji. Zajmuje się systemami, które mają działać w skali liczonej w milionach klientów i niezliczonych zależnościach, również wtedy, gdy ich poszczególne części zawodzą. Był jednym z publicznych promotorów architektury, która pomogła przekształcić wewnętrzne potrzeby Amazona w AWS, a jego blog All Things Distributed od lat obejmuje chmurę, uczenie maszynowe, AI i coroczne prognozy technologiczne.
Dlatego rozmowa z nim jest ciekawsza wtedy, gdy nie traktuje się jej jak okazji do poznania kolejnej funkcji Bedrocka czy następnego modelu Nova. Najważniejsze jest to, co mówi między produktowymi nazwami: iż generatywna AI nie przywróci nam pewności, którą tracimy. Przeciwnie, wymusi budowę nowej architektury zaufania. Dla polskiego użytkownika elektroniki oznacza to zmianę sięgającą znacznie dalej niż wybór czatbota. Dotyczy opinii, według których kupujemy telewizor, zabezpieczeń inteligentnego domu, połączeń wideo, bankowości, usług publicznych i agentów, którym producenci chcą oddać klucze do naszych kont.
Człowiek od awarii
 Werner Vogels
Żeby zrozumieć ostrożność Vogelsa trzeba pamiętać, z jakiej tradycji inżynierskiej się wywodzi. System rozproszony nie jest pojedynczym komputerem, który albo działa, albo nie. To orkiestra maszyn, sieci, baz danych i usług, w której stale coś zwalnia, traci łączność, zwraca stary stan albo po prostu umiera. Zadaniem architekta nie jest więc magiczne usunięcie awarii, ale takie zaprojektowanie całości, aby lokalna usterka nie zamieniła się w globalną katastrofę.
Ta perspektywa pozwala lepiej zrozumieć jego podejście do AI. Model językowy może być imponujący, ale z punktu widzenia infrastruktury pozostaje zawodnym komponentem. Nie wolno mylić płynności wypowiedzi z gwarancją poprawności, a świetnego wyniku demonstracji z przewidywalnością w produkcji. Vogels sprowadza problem do zdania, które powinno być drukowane na pudełku każdego urządzenia reklamowanego jako „AI PC” albo „AI phone”.
Duże modele językowe nie są deterministyczne. To statystyczne generatory słów. Zostały zbudowane po to, by tworzyć to, co prawdopodobne, a nie to, co prawdziwe. Nie mają pojęcia prawdy ani inteligencji.
To brzmi brutalnie, zwłaszcza z ust szefa technologii korporacji inwestującej miliardy w generatywną AI. Nie jest jednak deklaracją, iż modele są bezużyteczne. Jest ostrzeżeniem przed błędem kategorii. Kalkulator ma policzyć, baza danych ma zwrócić zapisany rekord, a model językowy ma wygenerować przekonującą kontynuację wejściowego kontekstu. Czasem ta kontynuacja będzie doskonałą odpowiedzią. Czasem elegancko podanym fałszem. Sam model nie odczuwa różnicy.
Dla entuzjasty elektroniki to rozróżnienie jest bardziej praktyczne, niż się wydaje. Gdy telewizor generuje napisy, słuchawki streszczają rozmowę, telefon usuwa przechodnia ze zdjęcia, a system w samochodzie proponuje trasę to urządzenie nie „rozumie” rzeczywistości w ludzkim sensie. Składa wynik, który statystycznie pasuje do sytuacji. Im więcej producent oddaje mu sprawczości, tym ważniejsze staje się pytanie nie o to, jak dobry jest model w benchmarku, ale co się stanie, kiedy pomyli się właśnie teraz.
Zaufanie się skończyło
Vogels zaczyna opowieść o AI daleko od procesorów graficznych i parametrów. Cofnięciem do Amsterdamu z XV wieku, publicznych wag miejskich, późniejszych giełd i monumentalnych gmachów banków pokazuje, iż zaufanie zawsze miało swoją infrastrukturę. Waga na rynku pozwalała sprawdzić towar. Giełda tworzyła reguły dla ludzi finansujących dalekie wyprawy. Marmur banku niczego nie liczył lepiej, ale komunikował stabilność instytucji.
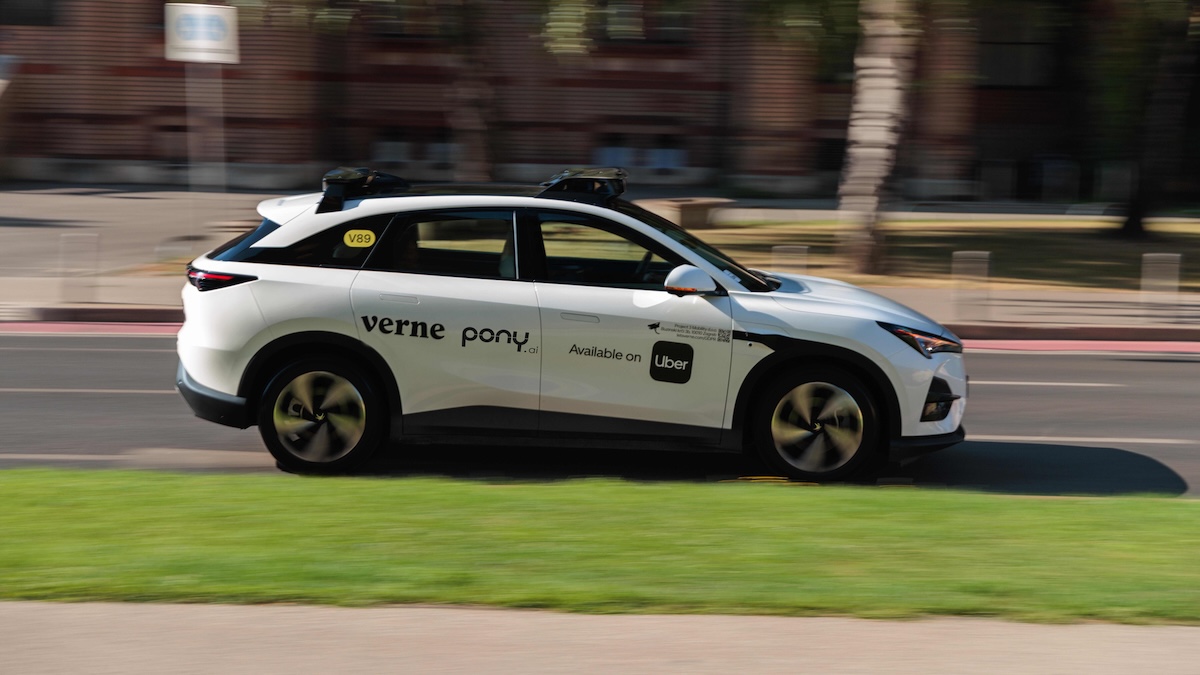 Autonomiczny Uber. Trzy dekady temu nikt by tego w ujęciu biznesowym i zaufania nie zrozumiał
Internet zmienił mechanizm, nie usunął potrzeby zaufania. Zaczęliśmy wsiadać do samochodów obcych ludzi, nocować w cudzych mieszkaniach i instalować kod napisany przez osoby, których nigdy nie poznamy. Rolę marmurowej fasady przejęły gwiazdki, komentarze, liczba pobrań i reputacja konta. To one miały odpowiadać na pytanie: czy można temu zaufać?
Weszliśmy w epokę Internetu i zaczęliśmy ufać obcym. Wsiadaliśmy do samochodów obcych ludzi, ufaliśmy oprogramowaniu napisanemu przez obcych i zatrzymywaliśmy się w domach należących do obcych. Recenzje i oceny reputacji stały się najważniejsze dla tego modelu.
Generatywna AI psuje ten mechanizm ekonomicznie. Dawniej stworzenie dziesięciu tysięcy choćby pozornie niezależnych opinii wymagało dziesięciu tysięcy ludzi albo przynajmniej kosztownej farmy kont. Dziś masową produkcję wiarygodnie brzmiących recenzji można zautomatyzować, zróżnicować językowo i dopasować do produktu. Vogels mówi, iż Amazon w jednym roku musiał usunąć 275 mln fałszywych opinii.
Tu potrzebne jest precyzyjne dopowiedzenie, bo liczba jest ogromna. Oficjalnie Amazon podaje, iż w 2024 r. proaktywnie zablokował ponad 275 mln podejrzanych fałszywych recenzji, zanim pojawiły się w sklepie; nie oznacza to więc 275 mln opublikowanych komentarzy później skasowanych ani 275 mln bezspornie udowodnionych oszustw. Skala pozostaje jednak absurdalna. To przemysłowa produkcja pozorów społecznego dowodu słuszności.
 Opinie klientów o produkcie są niezwykle ważne. W epoce tanich Dużych Modeli Językowych to problem
Polski klient wybierający tani projektor, powerbank, słuchawki TWS albo przystawkę z Android TV zna problem z praktyki. Karta produktu może mieć tysiące ocen, ale dotyczyć kilku połączonych wariantów. Nazwa marki może wyglądać, jakby powstała z losowania liter. Recenzje mogą być językowo poprawne, a mimo to nie mówić niczego o opóźnieniach dźwięku, realnej jasności, stabilności aplikacji czy zachowaniu sprzętu po pół roku. Po generatywnej AI ładny akapit przestał być choćby słabym dowodem, iż po drugiej stronie był człowiek.
Następna generacja zaufania musi opierać się na weryfikacji: czy potrafimy sprawdzić, co te systemy naprawdę robią?.
To być może najważniejsza teza całej rozmowy. Nie chodzi o przywrócenie dawnej niewinności Internetu, bo jej już nie będzie. Chodzi o przesunięcie ciężaru z wiarygodnego wyglądu na sprawdzalny proces. Zdjęcie, głos, pięć gwiazdek i pewny ton nie wystarczą. Potrzebny jest drugi kanał potwierdzenia, historia pochodzenia danych, ograniczone uprawnienia, zapis działań albo matematycznie sprawdzalna reguła.
Ryzyko ma suwak
W publicznej rozmowie o AI zbyt często wszystko wrzuca się do jednego worka. Błąd w zabawnym generatorze grafik i błąd w systemie oceniającym badanie medyczne stają się „halucynacją AI”, jakby miały ten sam ciężar. Vogels proponuje znacznie dojrzalszy model: ryzyko jest skalą, a poziom zabezpieczeń powinien zależeć od skutków pomyłki.
Ryzyko jest drugą stroną monety zaufania. o ile chodzi o tekst marketingowy, człowiek może go łatwo sprawdzić, a błąd jest względnie niegroźny. Ale jeżeli mogą wyciec dane pozwalające zidentyfikować osobę, albo mówimy o systemie medycznym czy rozwiązaniu obsługującym transakcje o dużej wartości, musimy wbudować weryfikację w cały proces.
To rozsądniejsze niż zarówno bezrefleksyjny zachwyt, jak i zakaz wszystkiego. Streszczenie instrukcji telewizora można gwałtownie przejrzeć. Automatyczne nazwanie albumu ze zdjęciami najwyżej stworzy zabawną pomyłkę. Agent mający dostęp do poczty, dysku, kalendarza, sklepu i karty płatniczej jest już inną klasą produktu. Nie dlatego, iż koniecznie korzysta z większego modelu, ale dlatego, iż błąd może przestać być tekstem na ekranie i stać się wykonanym przelewem, ujawnionym plikiem albo potwierdzonym zamówieniem.
W europejskich realiach ta intuicja ma również prawny odpowiednik. AI Act wymaga, by systemy wysokiego ryzyka dało się skutecznie nadzorować przez człowieka, a osoby sprawujące nadzór rozumiały możliwości i ograniczenia systemu oraz mogły interweniować. Na podmioty wdrażające takie rozwiązania nakłada obowiązek wyznaczenia ludzi mających odpowiednie kompetencje, szkolenie i uprawnienia. Innymi słowy: „człowiek w pętli” nie może być stażystą klikającym „zatwierdź” w tempie narzuconym przez algorytm.
Czarna skrzynka urzędu
Najbardziej sugestywnym przykładem Vogelsa nie jest futurystyczny bunt maszyn, tylko system urzędowy z Rotterdamu. Miasto używało algorytmu do wskazywania osób pobierających świadczenia, które należało skontrolować pod kątem oszustwa. Bezpośrednie dane o pochodzeniu nie były konieczne, aby wynik okazał się dyskryminujący. Wystarczyło coś innego.
Usunięto z zestawu wszystkie bezpośrednie dane dotyczące migracji. Pozostawiono jednak jeden wskaźnik: jak dobrze dana osoba mówi po niderlandzku. Okazało się, iż biegłość językowa jest silnie skorelowana ze statusem migracyjnym.
Dziennikarskie śledztwo dotyczące systemu potwierdziło istnienie mechanizmu, a jego szczegóły są jeszcze bardziej niepokojące. Model przetwarzał 315 zmiennych, w tym wiek, płeć, umiejętności językowe, dzielnicę, stan cywilny i subiektywne oceny pracowników socjalnych, a wynik służył do kierowania ludzi na kontrole. Biegłość w niderlandzkim działała jako pośredni wskaźnik pochodzenia; osoby słabo znające język były ponad dwukrotnie częściej flagowane niż osoby biegle nim władające.
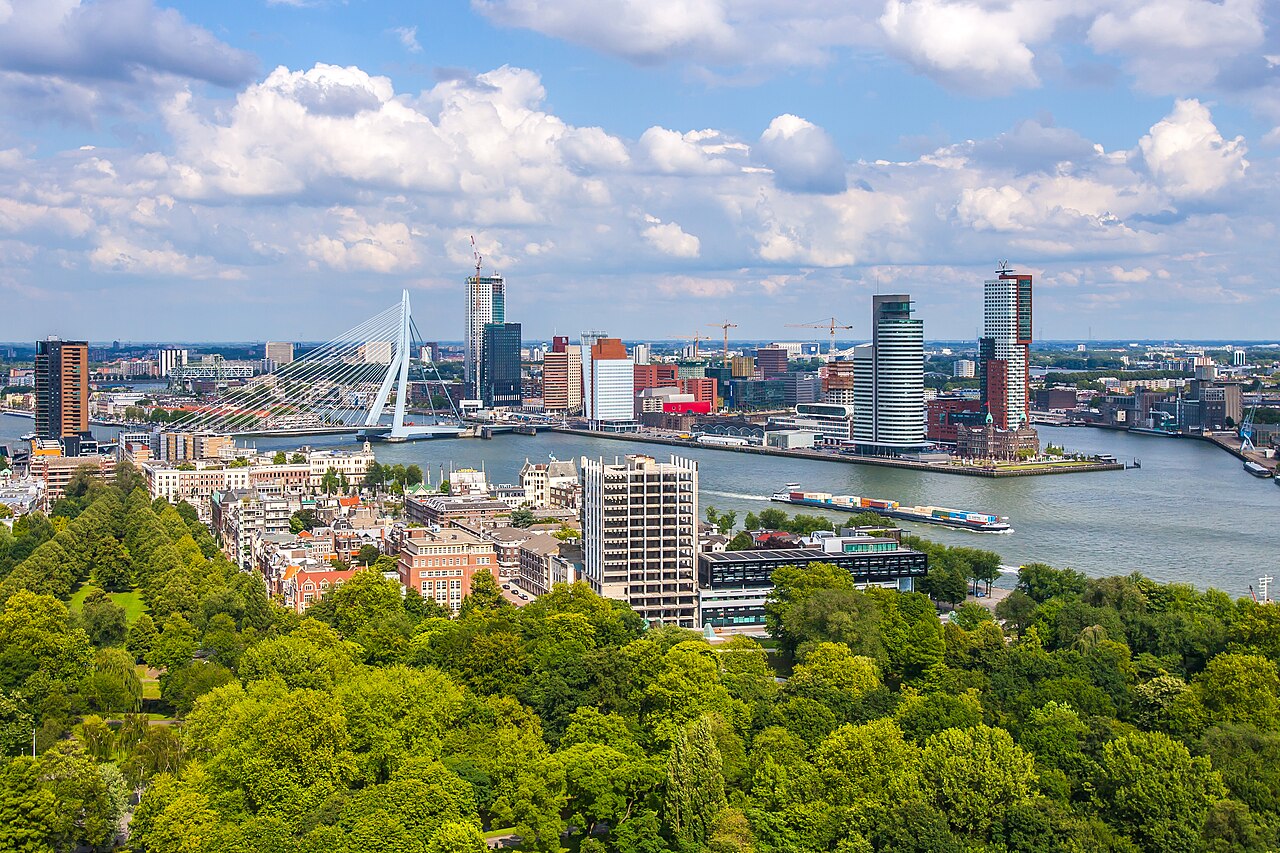 Rotterdam
Ten przypadek pokazuje, dlaczego samo wykreślenie wrażliwej kolumny z arkusza nie usuwa uprzedzenia. Kod pocztowy może sugerować status majątkowy. Historia językowa może sugerować pochodzenie. Model może uznać błąd w formularzu za sygnał oszustwa, a później wzmacniać tę zależność na danych z kontroli, do których sam wcześniej wytypował ludzi. Z pozoru neutralne dane tworzą pętlę, w której wcześniejsza podejrzliwość produkuje materiał potwierdzający przyszłą podejrzliwość.
Vogels zwraca uwagę, iż problem pogłębia nieprzejrzystość modeli. jeżeli organizacja nie potrafi wyjaśnić, dlaczego system podejmuje decyzję, to nie wystarczy zapewnienie, iż „nie kazano mu dyskryminować”. To szczególnie ważne w Polsce, gdzie AI będzie trafiać do administracji, bankowości, rekrutacji, ochrony zdrowia i ubezpieczeń. Obywatela nie interesuje przecież, czy krzywdząca decyzja była złośliwa. Interesuje go, czy można ją zakwestionować, odtworzyć i naprawić.
Agent to nie czatbot
Jeszcze niedawno generatywna AI była przede wszystkim oknem rozmowy. Użytkownik wpisywał polecenie, dostawał tekst i sam decydował, co dalej. Agent zmienia układ sił, ponieważ może korzystać z narzędzi: otwierać pliki, wywoływać API, rezerwować bilety, modyfikować kod, wysyłać wiadomości albo uruchamiać płatności. Pomyłka przestaje być odpowiedzią. Staje się działaniem.
Agenci są zasadniczo inni, ponieważ podejmują działania – przenoszą pieniądze, rezerwują loty albo uzyskują dostęp do systemów. o ile agent tylko zarządza rodzinnym kalendarzem, nikt nie przejmuje się rozbudowanymi parametrami bezpieczeństwa. To zupełnie inna historia, gdy budujesz system medyczny albo zarządzasz wrażliwymi danymi klientów.
Dla użytkownika inteligentnego domu różnica jest łatwa do przeoczenia. Asystent, który odpowiada jaka będzie pogoda ma niewielką sprawczość. Ten sam asystent połączony z zamkiem, alarmem, kamerami, bramą garażową i kontem zakupowym ma zestaw uprawnień przypominający cyfrowy pęk kluczy. choćby jeżeli sam model działa „tylko w chmurze” to skutki jego decyzji pojawiają się w fizycznym mieszkaniu.
Vogels opowiada się za barierami po obu stronach. Trzeba ograniczyć samego agenta, ale również odpowiednio zabezpieczyć usługi, do których agent się odwołuje. API nie powinno wykonywać dowolnej operacji tylko dlatego, iż żądanie przyszło z poprawnym tokenem. Powinno znać zakres uprawnień, limity wartości, dopuszczalne zasoby i sytuacje wymagające dodatkowego potwierdzenia.
To działa w dwie strony: kontrolujemy system agenta, ale równie rygorystycznie chronimy zasoby, do których uzyskuje dostęp.
Jego przykład jest przyziemny i przez to celny. jeżeli agent ma zarezerwować lot drugą klasą to system przewoźnika powinien uniemożliwić mu zakup biletu pierwszej klasy za 15 tys. dol., chyba iż użytkownik wyraźnie zatwierdzi zmianę. W domu odpowiednikiem byłaby aplikacja energetyczna, która może obniżyć temperaturę o dwa stopnie, ale nie może odłączyć ogrzewania podczas mrozu; albo asystent zakupowy, który potrafi dołożyć produkt do koszyka, ale nie sfinalizuje zamówienia ponad określony limit.
To w gruncie rzeczy stara zasada najmniejszych uprawnień, tylko zastosowana do nowego, mniej przewidywalnego aktora. Agent powinien dostać dokładnie tyle dostępu, ile wymaga zadanie, na możliwie krótki czas i bez domyślnej drogi do rozszerzenia kompetencji. Vogels ujmuje to bez korporacyjnych ozdobników.
Jeżeli korzystasz z tej technologii, musisz opisać dokładnie, co agenci mogą robić – i absolutnie nic ponad to. jeżeli nie wdrożysz barier ochronnych, jesteś zdany na siebie.
Amazon sprzedaje pasy
W tym miejscu rozmowa naturalnie skręca w stronę Amazon Bedrock, czyli platformy AWS zapewniającej dostęp do modeli wielu dostawców wraz z narzędziami do budowania aplikacji generatywnych. Vogels podkreśla możliwość definiowania wspólnych barier ochronnych niezależnie od tego, czy organizacja korzysta z Claude’a, Qwena, DeepSeeka czy innego modelu.
Dokumentacja AWS potwierdza, iż Bedrock Guardrails może oceniać zarówno wejścia użytkownika, jak i odpowiedzi modelu, a polityki obejmują między innymi filtry treści, zakazane tematy, wrażliwe informacje i określone słowa. Te same mechanizmy można stosować z modelami tekstowymi i graficznymi, agentami oraz bazami wiedzy. Platforma oferuje dostęp do modeli Amazona i wielu zewnętrznych firm, w tym Anthropic, DeepSeek, OpenAI i Qwen.
Nie należy jednak mylić tej części rozmowy z neutralnym wykładem uniwersyteckim. Amazon zarabia na chmurze i sprzedaje narzędzia mające rozwiązywać problem, o którym mówi jego CTO. Gdy Vogels zachwala modelową niezależność Bedrocka to prezentuje jednocześnie sensowną zasadę architektoniczną i argument handlowy. Jedno nie unieważnia drugiego, ale dojrzały odbiorca powinien widzieć obie warstwy.
Bariera ochronna nie jest też polem siłowym. Musi zostać poprawnie zaprojektowana, przetestowana, wdrożona i rzeczywiście wywołana. Dokumentacja AWS zwraca uwagę, iż niektóre kontrole oparte na automatycznym wnioskowaniu wymagają adekwatnego oznaczenia treści; bez niego sprawdzenie może się nie uruchomić, mimo iż API nie zwróci błędu. To doskonałe przypomnienie, iż zakup produktu „security” nie jest tym samym co bezpieczny system.
Maszyna sprawdzi maszynę
Skoro człowiek nie jest w stanie manualnie kontrolować każdego działania to część nadzoru również trzeba zautomatyzować. Vogels wskazuje dwie drogi. Pierwsza to automated reasoning, czyli przekład reguł na logikę formalną i matematyczne sprawdzanie, czy odpowiedź albo działanie pozostaje z nimi zgodne. Druga przypomina rozwiązania z systemów krytycznych: kilka niezależnych implementacji ocenia ten sam problem, a wynik odstający zostaje odrzucony.
Jeżeli potrafisz formalnie opisać swój system, możesz matematycznie dowieść poprawności jego wyników.
W Bedrocku takie kontrole mają wykrywać sprzeczność odpowiedzi z polityką, wskazywać niejawne założenia i dostarczać sprawdzalne wyjaśnienie, która reguła została spełniona albo naruszona. Nie jest to jednak uniwersalny wykrywacz prawdy. Matematycznie można sprawdzić zgodność z uprzednio zdefiniowanym zbiorem zasad. jeżeli zasady są niepełne, źle zapisane albo dotyczą dziedziny, której nie da się sensownie sformalizować to dowód nie uratuje systemu.
Drugi pomysł jest bardziej intuicyjny: zamiast pytać pięć razy ten sam model należy zestawić różne modele, zbudowane przez różne zespoły i na innych fundamentach. Vogels odwołuje się do wielowersyjnego programowania w lotnictwie, gdzie niezależne komputery porównują wyniki i „głosują” nad działaniem.
W systemach AI wysokiego ryzyka powinniśmy zastosować ten sam wzorzec architektoniczny. Wysyłasz polecenie do trzech różnych modeli i porównujesz odpowiedzi. jeżeli wszystkie się zgadzają, idziesz dalej. najważniejsze jest użycie różnych modeli. o ile pięć razy zadasz to samo pytanie pięciu instancjom Claude’a, dostaniesz ten sam rodzaj odpowiedzi. Zamiast tego użyj Qwena, DeepSeeka i Claude’a, porównaj wyniki i pozwól im głosować.
To atrakcyjna koncepcja, ale nie darmowy cud. Trzy modele oznaczają wyższy koszt, większe opóźnienie i bardziej złożoną orkiestrację. Co ważniejsze, modele mogą dzielić źródła danych, popularne błędne przekonania albo podobne metody dostrajania, więc jednomyślność przez cały czas nie jest równoznaczna z prawdą. Głosowanie zwiększa odporność przede wszystkim wtedy, gdy błędy są wystarczająco niezależne.
Dla zwykłego użytkownika odpowiednikiem nie musi być uruchamianie trzech płatnych modeli przy każdym pytaniu. Przy zakupie telewizora „wielomodelowe głosowanie” może oznaczać zestawienie pomiarów z profesjonalnej recenzji, dokumentacji producenta, doświadczeń użytkowników po aktualizacji i własnych potrzeb. Przy ważnej informacji zdrowotnej – sprawdzenie źródła i konsultację z lekarzem. Sednem nie jest liczba chatbotów, ale rezygnacja z jednego, niekontrolowanego punktu prawdy.
Deepfake zdał wideoweryfikację
Przez lata szkolenia bezpieczeństwa powtarzały prostą radę: jeżeli wiadomość od przełożonego wygląda podejrzanie to potwierdź prośbę innym kanałem. Pracownik firmy Arup zrobił właśnie to. Po otrzymaniu podejrzanej prośby o poufny transfer wziął udział w wideokonferencji z osobami, które wyglądały i brzmiały jak dyrektor finansowy oraz znani współpracownicy. Następnie przelał równowartość około 25 mln dol. Problem w tym, iż pozostali uczestnicy byli cyfrowymi imitacjami.
Pracownik, zachowując sceptycyzm, poprosił o wideorozmowę. Dołączył ‘CFO’ wraz z kilkoma rozpoznawalnymi ‘współpracownikami’. Uspokojony pracownik przelał 25 mln dolarów. W rzeczywistości wszyscy na tym połączeniu byli deepfake’ami.
To historia graniczna, bo ofiara nie zignorowała zasad bezpieczeństwa. Zastosowała regułę, która jeszcze niedawno uchodziła za rozsądną: zobacz człowieka, usłysz jego głos, zadaj pytanie. Generatywna AI obniżyła wartość tego dowodu. Oszust nie musiał włamywać się do wewnętrznej infrastruktury firmy; Arup potwierdził, iż systemy nie zostały naruszone. Atakował protokół zaufania między ludźmi.
Vogels twierdzi, iż tylko około jedna osoba na tysiąc potrafi niezawodnie rozpoznać wysokiej jakości deepfake. To mocna liczba, dla której w publicznie dostępnych materiałach nie ma tu wystarczająco solidnego, niezależnego potwierdzenia, więc bezpieczniej potraktować ją jako ostrzegawczą ocenę rozmówcy, a nie ustalony parametr ludzkiej percepcji. Sam wniosek nie wymaga jednak tak skrajnej statystyki: wzrok i słuch nie mogą już być jedynymi mechanizmami autoryzacji operacji wysokiej wartości.
W praktyce potrzebne są procedury odporne na podrobienie jednego medium: oddzwonienie na wcześniej zapisany numer, potwierdzenie w niezależnym systemie, wieloosobowa autoryzacja, limity transakcji, podpis kryptograficzny albo umówione hasło, którego nie da się pozyskać z publicznych nagrań. Dla rodziny może to oznaczać prostą frazę awaryjną używaną przy telefonach o rzekomym wypadku. Dla firmy – proces, którego nie wolno ominąć choćby „na pilną prośbę prezesa”.
Nie możemy już polegać wyłącznie na ludzkich oczach. Potrzebujemy innych, weryfikowalnych mechanizmów kryptograficznych i systemowych. Źli aktorzy przyjmują tę technologię równie gwałtownie jak dobrzy.
Stare dziury, nowe tempo
Łatwo wyobrażać sobie cyberwojnę AI jako pojedynek supermodeli odkrywających nieznane wcześniej luki typu zero-day. Vogels studzi tę wizję przypomnieniem, iż ogromna część realnych incydentów przez cały czas zaczyna się od błędów banalnych: danych dostępowych pozostawionych w publicznym repozytorium, źle skonfigurowanego zasobu chmurowego, starego systemu albo braku podstawowej segmentacji.
„Liczba danych uwierzytelniających AWS, które ludzie przez pomyłkę zostawiają w publicznych repozytoriach GitHuba, jest oszałamiająca. Inni pozostawiają całkowicie otwarte zasobniki S3, sądząc, iż nikt nie odgadnie ich nazwy. To nie jest problem AI. To problem podstawowej higieny bezpieczeństwa”.
Ten fragment powinien szczególnie zainteresować miłośników inteligentnego domu. Rynek elektroniki użytkowej pełen jest urządzeń, których producent konkuruje ceną i czasem wprowadzenia na rynek, nie długością wsparcia. Telewizor, kamera IP, wideodzwonek czy otwieracz bramy mogą działać latami po ostatniej aktualizacji. Z perspektywy użytkownika przez cały czas „są sprawne”, ale z perspektywy napastnika bywają porzuconym komputerem z mikrofonem, kamerą i dostępem do domowej sieci.
Pomyślmy o automatyce domowej. Wiele urządzeń smart home działa na bardzo starych, niełatanych wersjach Linuksa. Hakerzy nie potrzebowali AI ani luk zero-day, żeby włamać się do inteligentnego telewizora czy otwieracza bramy garażowej. Podstawowe podatności istniały zawsze.
AI może tę sytuację poprawić i pogorszyć jednocześnie. Obrońca wykorzysta modele do przeglądania kodu, wykrywania błędnych konfiguracji i priorytetyzowania alarmów. Atakujący zautomatyzuje rozpoznanie, przygotowanie spersonalizowanej wiadomości i adaptację skryptu do kolejnych celów. Przewaga napastnika polega na asymetrii: jego program musi zadziałać raz i przez chwilę; producent powinien chronić wszystkie egzemplarze przez lata.
 Smart home to super sprawa. Ale kiedy ostatnio aktualizowaliście swoje… żarówki?
Dla kupującego sprzęt oznacza to, iż długość wsparcia i jakość procesu aktualizacji powinny być elementem specyfikacji równie realnym jak liczba portów HDMI 2.1. Warto sprawdzić, czy urządzenie pozwala wyłączyć zdalny dostęp, czy dostaje poprawki automatycznie, czy działa w odseparowanej sieci dla IoT i czy po upadku chmurowej usługi zachowuje podstawową funkcjonalność lokalną. AI nie zastąpi tych fundamentów. Może co najwyżej szybciej ujawnić, iż ich nie ma.
Odpowiedzialność nie znika
Najkrótsza odpowiedź Vogelsa pada przy pytaniu o to, kto odpowiada, gdy firma sama określa bariery dla wdrażanego systemu. Nie model, nie „algorytm”, nie abstrakcyjna innowacja. Organizacja, która dała mu dane, narzędzia i zgodę na działanie.
Ty odpowiadasz. Zawsze jesteś na pierwszej linii odpowiedzialności. jeżeli nie wdrożysz adekwatnych barier i coś pójdzie źle, nie możesz pójść do regulatora i powiedzieć: ‘To była wina AI’. To tak nie działa. Firma odpowiada. Pozwoliłeś tej technologii działać, więc ponosisz odpowiedzialność.
To ważne także na poziomie konsumenckim. Producent nie powinien zasłaniać się niedeterministycznością modelu, jeżeli jego agent zamówił niewłaściwy produkt albo ujawnił dane. Bank nie powinien uznawać wyniku scoringu za siłę natury. Urząd nie może traktować modelu jak anonimowego urzędnika, którego decyzji nie da się wyjaśnić. Automatyzacja procesu nie automatyzuje odpowiedzialności moralnej i prawnej.
Jest tu też odpowiedź na modne sformułowanie „AI podjęła decyzję”. AI niczego nie wdraża sama. Ktoś wybiera model, dane, zakres uprawnień, progi ryzyka, sposób prezentowania wyniku i procedurę odwołania. choćby decyzja, by nie wiedzieć, jak system dochodzi do odpowiedzi, pozostaje decyzją organizacji.
Lekarz przez cały czas podpisuje wynik
Najlepsze przykłady AI w ochronie zdrowia nie przypominają wszechwiedzącego lekarza z ekranu. Są węższe, mniej widowiskowe i przez to bardziej wiarygodne. Model może być dodatkową parą oczu, systemem wczesnego ostrzegania albo filtrem kierującym trudny przypadek do specjalisty. Nie musi stawiać ostatecznej diagnozy, aby ratować czas i życie.
W obszarach krytycznych, takich jak ochrona zdrowia, model ‘human in the loop’ jest niezbędny.
Vogels przywołuje szwedzkie badania przesiewowe piersi, w których analiza obrazu przez AI wspiera radiologów. Najnowsze wyniki randomizowanego badania MASAI na blisko 106 tys. kobiet wskazały o 29 proc. więcej wykrytych nowotworów w grupie ze wsparciem AI: 338 przypadków wobec 262 przy tradycyjnym odczycie. Późniejsze wyniki pokazały również 12 proc. mniej nowotworów wykrywanych pomiędzy badaniami przesiewowymi.
AI jest bezcenną drugą parą oczu, ale ostateczną diagnozę przez cały czas stawia radiolog.
To model współpracy, a nie zastąpienia. Człowiek wnosi odpowiedzialność, kontekst kliniczny i możliwość rozmowy z pacjentem. Maszyna wnosi konsekwencję w analizie ogromnej liczby obrazów i zdolność wskazania wzorca, który mógłby zostać przeoczony. Najważniejsze jest nie to, kto „wygra” porównanie, ale czy połączony system wykrywa więcej chorób bez niedopuszczalnego wzrostu fałszywych alarmów.
Vogels opisuje również aplikację, w której pacjent regularnie fotografuje zmianę skórną. System nie wydaje wyroku, ale po zauważeniu istotnej zmiany zaleca kontakt z lekarzem. To subtelna, ale fundamentalna granica produktu. „Idź na konsultację” jest działaniem odwracalnym i ostrożnym. „To na pewno nic groźnego” może uśpić czujność z dramatycznym skutkiem.
Podobna zasada działa poza medycyną. Czujnik przy łóżku starszej osoby nie musi diagnozować udaru. Wystarczy, iż zawiadomi opiekuna, jeżeli ktoś wstał w nocy i nie wrócił przez piętnaście minut. Inteligentne pudełko na leki nie powinno prowadzić terapii, ale może powiadomić bliską osobę o pominiętej dawce. Dobra automatyzacja często nie usuwa człowieka z procesu. Sprawia, iż człowiek pojawia się we adekwatnym momencie.
AI musi mówić lokalnie
Dla polskiego odbiorcy jeden z najciekawszych wątków rozmowy dotyczy kultury. Wielki model amerykański może świetnie tłumaczyć zdania na polski, a jednocześnie odpowiadać w sposób głęboko amerykański: inaczej rozkładać akcenty, unikać innych tematów, opierać przykłady na obcym systemie prawnym i nie rozumieć kodów kulturowych, które dla miejscowego odbiorcy są oczywiste.
Jeżeli polegasz wyłącznie na ogromnych modelach amerykańskich, choćby gdy przetłumaczysz polecenie z polskiego, ostatecznie dostaniesz odpowiedź skoncentrowaną na Ameryce.
Nie chodzi wyłącznie o odmianę przez przypadki. Model może doskonale zbudować polskie zdanie, a mimo to nie rozumieć, czym w praktyce różni się urząd gminy od urzędu skarbowego, jakie skojarzenia budzi konkretna lektura, dlaczego pewien żart jest w punkt, a inny obraźliwy, albo jak rozmawia się z pacjentem w konkretnym regionie. Kultura nie jest wtyczką językową. Jest warstwą znaczeń, norm i doświadczeń.
Potrzebujemy modeli świadomych kultury. Niektórzy nazywają je niszowymi, ale są niezbędne. Nie chodzi tylko o tłumaczenie języka. Chodzi o osadzenie lokalnej kultury w języku.
Vogels podaje przykład Jacaranda Health w Kenii. System SMS pozwala przyszłym matkom zadawać pytania dotyczące ciąży i odpowiada w lokalnym dialekcie, co wzmacnia zaufanie. Jednocześnie słowa wysokiego ryzyka, takie jak „krwawienie”, mają omijać automatyczną odpowiedź i natychmiast kierować sprawę do człowieka z personelu medycznego. Lokalność i bezpieczeństwo nie są tu osobnymi dodatkami, ale warunkiem użyteczności.
Polska nie startuje od zera. PLLuM jest rodziną modeli przeznaczonych do języka polskiego, rozwijaną przez krajowe instytucje naukowe i publiczne; projekt ma uwzględniać polską gramatykę, kontekst społeczno-kulturowy oraz język urzędowy. Bielik jest natomiast otwartą, rozwijaną społecznościowo rodziną modeli trenowanych przede wszystkim na polskojęzycznych zbiorach i krajowym dziedzictwie kulturowym, dostępną również do komercyjnego użycia na licencji Apache 2.0.
To nie znaczy, iż model lokalny automatycznie wygra każdy benchmark z gigantem trenowanym za miliardy dolarów. Może jednak okazać się lepszy w precyzyjnie wybranym zadaniu: rozumieniu polskiego dokumentu, klasyfikacji krajowej korespondencji, obsłudze specyficznej terminologii albo działaniu lokalnie na sprzęcie organizacji. Suwerenność technologiczna nie polega na budowaniu największego modelu świata za wszelką cenę. Polega na tym, by mieć realny wybór i nie uzależniać krytycznej usługi od jednego zewnętrznego interfejsu.
Zachód buduje kolosy
Vogels opisuje dwa konkurujące sposoby myślenia o rynku modeli. W jego ujęciu podejście amerykańskie jest mocno kapitalistyczne: koncentruje się na coraz większych, drogich modelach granicznych, rozwijanych gwałtownie i sprzedawanych przedsiębiorstwom. Podejście azjatyckie częściej traktuje AI jak towar powszechnego użytku: model ma być lżejszy, tańszy i dostępny dla wielu zastosowań.
To oczywiście szerokie uproszczenie. „Azja” nie jest jednym rynkiem, podobnie jak każdy model amerykański nie jest automatycznie olbrzymem. Trafna pozostaje jednak obserwacja o utowarowieniu. o ile mniejszy model rozwiązuje zadanie wystarczająco dobrze to ogromny model traci przewagę uzasadniającą rachunek.
Jeżeli tworzysz prostą listę rekomendacji ‘najlepszych produktów’ na stronę internetową, kogo obchodzi użycie potężnego amerykańskiego modelu z 70 miliardami parametrów? Lekki i tani model wykona tę pracę wystarczająco dobrze za ułamek ceny.
To ważna lekcja również dla rynku elektroniki. Producenci lubią przedstawiać największy model jako odpowiednik najmocniejszego procesora. Tymczasem model dobrany do zadania przypomina raczej układ wyspecjalizowany. Do redukcji szumu w mikrofonie, klasyfikacji zdjęć, przewidywania zużycia energii czy rozpoznania komendy nie potrzeba zawsze chmurowego kolosa. Mniejszy model działający lokalnie może być szybszy, tańszy, bardziej prywatny i dostępny bez Internetu.
Wybór nie powinien więc zaczynać się od pytania „który model jest najmądrzejszy?”, ale od „jaka jakość jest potrzebna, jaki błąd jest dopuszczalny, ile kosztuje pojedyncze zadanie i gdzie mogą trafić dane?”. Benchmark ogólny jest tylko jednym z parametrów. Dla polskiej firmy równie ważne mogą być obsługa języka, licencja, możliwość wdrożenia we własnej infrastrukturze, przewidywalność kosztu i łatwość zmiany dostawcy.
Koszt gwałtownie staje się najważniejszym czynnikiem decydującym o tym, jaki model przedsiębiorstwo wdroży.
Trudno nie zauważyć, iż modelowa agnostyczność AWS jest zarazem strategią biznesową idealnie dopasowaną do takiego świata. jeżeli żaden model nie rządzi wiecznie to warto sprzedawać wspólną warstwę dostępu, zabezpieczeń i rozliczeń. Klient może zmieniać silniki, ale przez cały czas jedzie po drodze Amazona. Z jego perspektywy to wygoda i ograniczenie ryzyka migracji; z perspektywy AWS – sposób na pozostanie pośrednikiem niezależnie od zwycięzcy wyścigu modeli.
Tokeny też kosztują
Tradycyjne oprogramowanie przyzwyczaiło nas do przewidywalności. Ta sama formuła arkusza daje ten sam wynik. Ten sam rozkaz procesora, przy tych samych danych i stanie, zachowuje się identycznie. Agent oparty na modelu może wybrać inną ścieżkę, wykonać więcej kroków, ponownie załadować kontekst i zużyć wielokrotnie więcej tokenów. To utrudnia nie tylko testowanie, ale również budżetowanie.
Jednym z największych wyzwań dla firm jest dziś porównanie kosztu tych systemów z rzeczywistą jakością wyników. Przez długi czas organizacje rzucały się na AI z obawy, iż bez niej natychmiast wypadną z rynku. Po pierwsze, jutro nie zbankrutują. Po drugie, zaczynają rozumieć, iż uruchamianie tych modeli jest niezwykle drogie.
Vogels krytykuje środowiska programistyczne, które przy kolejnych działaniach wielokrotnie ładują cały kod lub kontekst, niepotrzebnie spalając tokeny. Jako odpowiedź wskazuje pamięć trwałą w narzędziach Amazon Q i Q Developer Agent, dzięki której system nie powinien za każdym razem rekonstruować całej historii. Znów jest to jednocześnie uwaga architektoniczna i prezentacja produktu Amazona.
Dla konsumenta koszt tokenów bywa ukryty w abonamencie, limicie „zaawansowanych” zapytań albo pogorszeniu jakości po przekroczeniu progu. Dla firmy skala ujawnia wszystko. jeżeli agent wykonuje dziesięć kroków tam, gdzie wystarczyły dwa, różnica mnoży się przez tysiące pracowników i miliony operacji. Im większą swobodę planowania dostaje system, tym trudniej przewidzieć koszt najgorszego przypadku.
Rozsądna architektura będzie więc mieszać technologie. Deterministyczna reguła sprawdzi limit. Wyszukiwarka znajdzie dokument. Klasyczny model prognostyczny policzy popyt. Mały model sklasyfikuje wiadomość. Duży model językowy zajmie się zadaniem wymagającym elastycznej interpretacji. Używanie LLM-a do wszystkiego przypomina montowanie gamingowej karty graficznej w czajniku tylko dlatego, iż jest najmocniejszym układem w katalogu.
Nie trzeba naginać ogromnego, drogiego modelu językowego do prognozowania, skoro wyspecjalizowana usługa matematyczna zrobi to lepiej i taniej.
Czasem AI jest zła
Najbardziej odświeżająca część rozmowy nie dotyczy tego, co AI potrafi, tylko tego, gdzie nie należy jej wciskać. Vogels opowiada o norweskiej firmie finansowej, która miała zwolnić połowę pracowników call center, licząc na automatyzację obsługi. Klienci dzwonili jednak często nie z banalnym pytaniem o saldo, ale dlatego, iż nie mogli spłacić rachunków i znajdowali się w trudnej sytuacji. System wykonywał reguły, ale nie oferował empatii ani ludzkiego osądu, więc firma musiała ponownie zatrudniać ludzi.
To anegdota bez ujawnionej nazwy przedsiębiorstwa, dlatego nie należy na jej podstawie budować statystyki dla całego rynku. Dobrze obrazuje jednak błąd projektowy: automatyzowano nie czynność, ale relację. Odpowiedź mogła być formalnie poprawna i zarazem całkowicie nieadekwatna do sytuacji człowieka.
Czasem AI jest po prostu niewłaściwą technologią dla danego problemu.
W elektronice użytkowej podobny błąd widać, gdy producent zastępuje prosty, dobrze działający interfejs rozmową z modelem. Ustawienie źródła HDMI nie wymaga kreatywności. Wyłączenie poprawiacza płynności nie powinno zależeć od humoru asystenta. Automatyczne rozpoznanie intencji jest świetne jako skrót, ale użytkownik przez cały czas potrzebuje przewidywalnej ścieżki manualnej i jasnej informacji, co urządzenie właśnie zmieniło.
Technologia jest dobra wtedy, gdy usuwa tarcie, a nie wtedy, gdy zasłania brak dobrze zaprojektowanej usługi. Chatbot na stronie operatora nie jest innowacją, jeżeli utrudnia dotarcie do człowieka. Agent zakupowy nie pomaga, jeżeli finansuje model biznesowy oparty na prowizji od polecanych ofert. „Inteligentna” funkcja obrazu nie jest wartością, jeżeli nie da się jej wyłączyć i sprawdzić, co robi z materiałem.
Polska używa, ale nie ufa
Vogels zwraca uwagę na lukę edukacyjną obejmującą zarówno programistów, jak i regulatorów. W rozmowie przywołuje badanie DevHorizon, według którego Polska ma ponad pół miliona deweloperów, ponad 90 proc. korzysta z narzędzi AI, ale tylko około 40 proc. weryfikuje i ufa wynikom. 87 proc. polskich programistów używa AI codziennie, 97 proc. przynajmniej raz w tygodniu, a średnia deklarowana oszczędność wynosi 7,3 godziny tygodniowo; badanie przeprowadzono na próbie 500 aktywnych deweloperów i na zlecenie AWS.
Te liczby warto czytać ostrożnie. Badanie zamawiała firma sprzedająca usługi AI i chmurowe, a deklarowana oszczędność czasu nie jest tym samym co zmierzony wzrost produktywności całej organizacji. Jednocześnie skala użycia pokazuje, iż narzędzia przestały być ciekawostką. Problem przesunął się z „czy programiści użyją AI?” na „jak kontrolują kod, który AI wytwarza?”.
Nie ma żadnego wstydu we wciśnięciu pauzy po to, by przeszkolić zespół.
To zdanie jest antidotum na korporacyjny lęk przed przegapieniem rewolucji. Firma nie zbankrutuje jutro tylko dlatego, iż nie wdrożyła agenta do każdego procesu. Znacznie szybciej może ucierpieć, gdy wdroży go bez właściciela ryzyka, monitoringu, limitów kosztu i procedury awaryjnej. Edukacja nie powinna przy tym oznaczać wyłącznie kursu promptowania. Potrzebne są kompetencje z ochrony danych, ewaluacji, cyberbezpieczeństwa, prawa i projektowania procesów.
Vogels przyznaje, iż po miesięcznej przerwie od wiadomości technologicznych sam czuł się przytłoczony tempem zmian. jeżeli człowiek zajmujący stanowisko CTO Amazona może mieć problem z uporządkowaniem potoku premier to nie ma sensu wymagać od przeciętnego użytkownika śledzenia każdej wersji modelu i każdego benchmarku. Dojrzały rynek powinien oferować stabilne gwarancje, czytelne okresy wsparcia i porównywalne parametry, a nie zmuszać klienta do studiowania codziennych rankingów.
Znuży nas syntetyczność
Vogels przewiduje też kulturową reakcję obronną. Im więcej sieć wypełnia się poprawnymi, gładkimi i pozbawionymi ryzyka tekstami, tym większą wartość może odzyskać rozpoznawalny ludzki głos. Nie dlatego, iż każdy człowiek pisze lepiej od modelu. Dlatego, iż człowiek ma doświadczenie, stawkę, odpowiedzialność i może pokazać, skąd wziął swój osąd.
Jestem przekonany, iż za kilka lat ludzie będą mieli serdecznie dość treści generowanych przez AI.
Dla mediów technologicznych to nie musi być katastrofa. AI potrafi przerobić specyfikację na artykuł w kilka sekund, ale nie usiądzie przed telewizorem w zaciemnionym pokoju, nie zauważy irytującego błędu po aktualizacji i nie będzie musiała odpowiedzieć czytelnikowi, który wydał pieniądze na podstawie rekomendacji. Gdy syntetycznego tekstu jest nieskończenie dużo to przewagę odzyskują pomiar, doświadczenie, podpis i reputacja budowana przez lata.
Problem w tym, iż wykrywanie treści AI jest kolejnym wyścigiem zbrojeń. Vogels przytacza historię nauczyciela, który miał ukryć w poleceniu biały tekst niewidoczny dla uczniów; osoby bezmyślnie kopiujące całość do modelu otrzymały charakterystyczne, dziwne fragmenty w pracach. To sprytna pułapka na konkretny sposób użycia, ale nie uniwersalny detektor autorstwa. W miarę jak modele uczą się unikać rozpoznawalnych wzorców, narzędzia kontrolne również muszą się zmieniać.
Ostatecznie będziemy musieli używać maszyn do sprawdzania maszyn.
Nie oznacza to, iż człowiek znika. Przesuwa się na wyższy poziom: ustala kryteria, bada przypadki sporne, rozpoznaje nieoczekiwane skutki i bierze odpowiedzialność. Automat może sprawdzić tysiące odpowiedzi pod kątem zgodności z regułą. Człowiek powinien zapytać, czy sama reguła ma sens.
Co z tego wynika
Z rozmowy z Wernerem Vogelsem nie wyłania się proste „AI jest dobra” ani „AI jest niebezpieczna”. Wyłania się coś bardziej użytecznego: architektura korzystania z narzędzia, któremu nie należy ufać w sposób bezwarunkowy. Im większa sprawczość systemu i dotkliwszy skutek błędu, tym mocniejsze powinny być ograniczenia, niezależna kontrola i możliwość zatrzymania procesu.
 Werner Vogels
Dla klienta elektroniki oznacza to zmianę kryteriów zakupowych. Liczy się już nie tylko jakość modelu, ale także miejsce przetwarzania danych, czas wsparcia urządzenia, zakres uprawnień agenta, możliwość wyłączenia funkcji, historia wykonanych działań i procedura na wypadek pomyłki. jeżeli producent nie potrafi jasno powiedzieć, co jego asystent może zrobić samodzielnie to pytanie nie brzmi „jak inteligentny jest ten produkt?”, ale „dlaczego miałbym wpuścić go do swojej poczty, domu i portfela?”.
Dla firm wniosek jest równie trzeźwiący. Najpierw należy zdefiniować problem, koszt akceptowalnego błędu i właściciela odpowiedzialności. Dopiero później wybrać model. Czasem najlepszym rozwiązaniem będzie wielki LLM, czasem mały model lokalny, czasem klasyczny algorytm, a czasem człowiek odbierający telefon. Sam fakt, iż proces da się zautomatyzować nie pozostało argumentem, by go automatyzować.
Vogels szacuje, iż około 95 proc. wdrożeń agentów AI będzie działać bez większych problemów, ale pozostaną przypadki, w których niewiedza albo zła intencja wypuści autonomiczny system bez kontroli. Tego odsetka nie należy traktować jak prognozy aktuarialnej. Ważniejsza jest asymetria: nie interesuje nas przeciętny agent, kiedy jeden wadliwie zabezpieczony agent ma dostęp do rekordu medycznego, przemysłowego API albo firmowego konta bankowego.
Jest w tej wizji pewien paradoks. Branża sprzedaje AI jako technologię usuwającą konieczność kontroli, tymczasem jej masowe wdrożenie tworzy zapotrzebowanie na jeszcze więcej kontroli: nad wejściem, wynikiem, kosztem, uprawnieniami, źródłami i odpowiedzialnością. Automatyzacja nie likwiduje pracy. Przenosi ją z wykonywania zadania na projektowanie granic i sprawdzanie skutków.
Najbardziej vogelsemowska lekcja nie brzmi więc: znajdź model, który nigdy się nie myli. Taki model nie istnieje. Brzmi: projektuj system tak, jakby jego najważniejszy komponent miał się pomylić – bo prędzej czy później się pomyli. Niech błąd zatrzyma się na bezpieczniku, zostanie zauważony przez inny model, trafi do człowieka albo odbije się od API, które nie pozwoli wykonać niedozwolonej operacji.
Jeśli zagrożone jest ludzkie życie, człowiek musi pozostać w pętli. Nie ma co do tego żadnych wątpliwości.
W świecie zachwyconym słowem „autonomiczny” brzmi to niemal konserwatywnie. A jednak pochodzi od człowieka, który od ponad dwudziestu lat odpowiada za kierunek technologiczny jednej z najpotężniejszych firm świata i współtworzył infrastrukturę nowoczesnej chmury. Vogels nie odrzuca przyszłości. Przypomina tylko, iż prawdziwie dojrzała technologia nie zaczyna się wtedy, gdy działa na scenie. Zaczyna się wtedy, gdy wiemy, co zrobi, kiedy scena zgaśnie, sieć zwolni, dane okażą się stronnicze, agent przekroczy uprawnienia, a model z pełnym przekonaniem poda odpowiedź, która jest jedynie prawdopodobna.