Nowy model OpenAI dostał kawałek jądra Linuksa i zaczął szukać dziur. Efekt to 948 unikalnych luk pozwalających na lokalne podniesienie uprawnień i rachunek, który każe na nowo przemyśleć ekonomię cyberbezpieczeństwa.
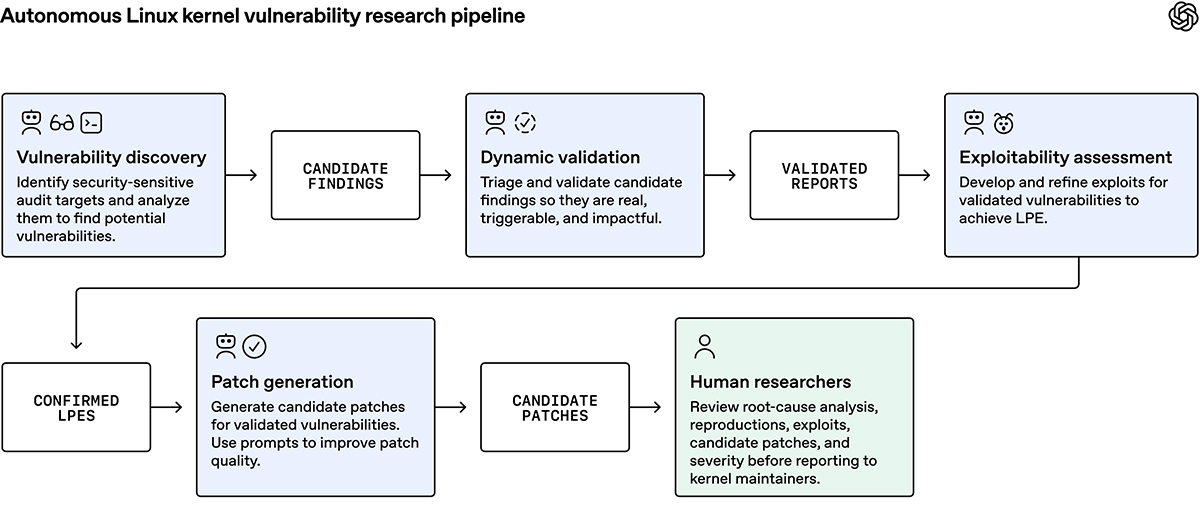
Jeszcze niedawno jednym z bardziej namacalnych sposobów mierzenia możliwości modeli AI w programowaniu było sprawdzanie, czy potrafią napisać poprawną funkcję, naprawić błąd albo odnaleźć podatność w niewielkim fragmencie kodu. OpenAI właśnie pokazało eksperyment należący do zupełnie innej kategorii wagowej. Firma zbudowała wieloetapowy, w dużej mierze autonomiczny system badania podatności i skierowała go na jądro Linuksa.
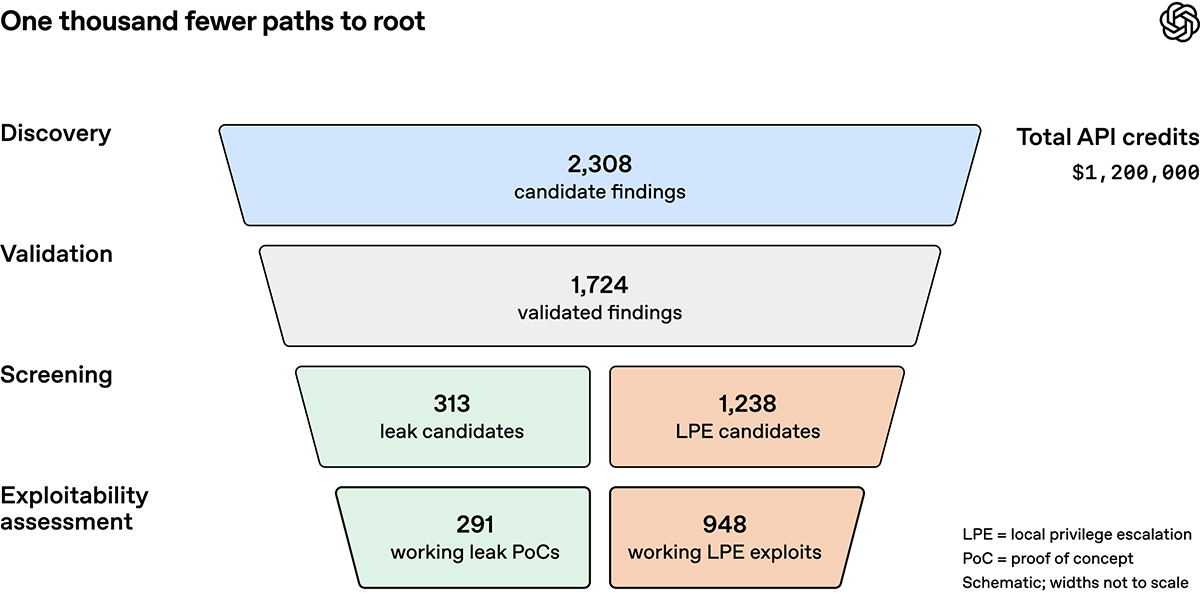
Rezultat jest co najmniej niewygodny dla wszystkich, kto lubił myśleć o poszukiwaniu poważnych luk jako o rzemiośle, którego nie da się łatwo skalować. System przeanalizował 2,8 mln linii kodu, wskazał 2308 potencjalnych problemów, dynamicznie odtworzył 1724 podatności, a ostatecznie doprowadził do opracowania 948 unikalnych przypadków lokalnego podniesienia uprawnień wraz z działającymi exploitami. To problemy, które mogą pozwolić użytkownikowi mającemu już niewielkie uprawnienia w systemie wejść na poziom roota.
Nie chodzi przy tym o zabawkowy system operacyjny przygotowany tak, by AI miała łatwiej. Celem był Linux. Ten sam fundament, na którym stoi ogromna część współczesnego świata komputerów.
AI przejrzała tylko 7 proc. jądra Linuksa
Skala projektu ma tutaj znaczenie. Kod jądra Linuksa liczy ponad 40 mln linii. Jego fragmenty znajdują się pod maską urządzeń z Androidem, infrastruktury chmurowej, superkomputerów i wielu innych systemów używanych przez miliardy ludzi. Jednocześnie powierzchnia ataku jest ogromna, bo obejmuje między innymi wywołania systemowe, sieć, systemy plików i sterowniki urządzeń. OpenAI nie kazało jednak modelowi czytać całego repozytorium od pierwszej do ostatniej linijki. Pierwszym etapem było znalezienie miejsc, w których w ogóle warto szukać.
 Milion dolarów na bezpieczeństwo Linuxa. Choć łatwo nie będzie
Agenci nazwani Scoutami analizowali katalogi i pliki pod kątem bezpieczeństwa i dostępności dla użytkownika o niskich uprawnieniach. Wytypowali 5034 cele obejmujące około 2,8 mln linii, a więc mniej więcej 7 proc. całej bazy kodu jądra. Sam ten etap kosztował 3426 dol. w kredytach API. Dopiero później do pracy zabrały się agenty analityczne. W ciągu 12 godzin wygenerowały, już po usunięciu duplikatów, 2308 potencjalnych odkryć. Za tę część eksperymentu OpenAI naliczyło 316 549 dol. kosztów API. I tu zaczyna się ciekawsza część całej historii. Znalezienie podejrzanie wyglądającego kawałka kodu nie oznacza przecież znalezienia prawdziwej podatności.
Nie wystarczyło powiedzieć: „tu chyba jest dziura”
To jeden z najważniejszych szczegółów publikacji OpenAI. Model nie ograniczał się do statycznego czytania kodu i produkowania tysięcy raportów, które ktoś później musiałby manualnie sprawdzić. Kolejny etap polegał na dynamicznej walidacji odkryć. Agent próbował przygotować proof of concept i odtworzyć problem w izolowanej maszynie wirtualnej z jądrem wykorzystującym Kernel Address Sanitizer. Obserwował wynik działania programu i konsolę systemową, a następnie poprawiał swój PoC tak długo, aż udało się odtworzyć problem albo wyczerpał możliwości przewidziane na daną próbę.
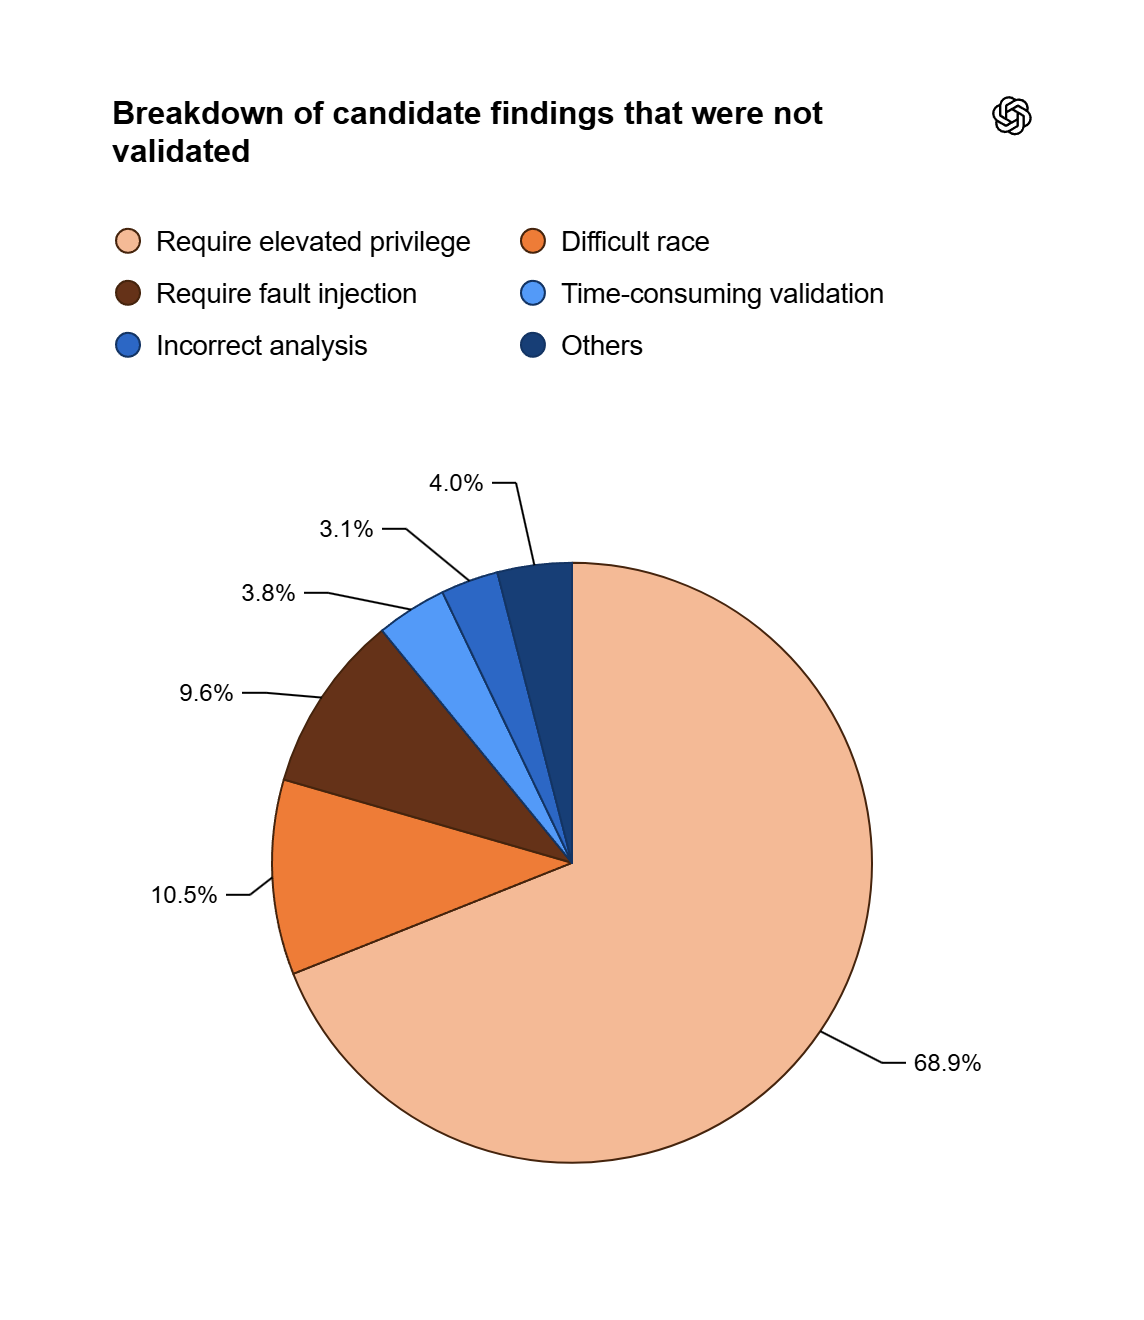
W ciągu 30 godzin system odtworzył 1724 z 2308 wskazanych wcześniej problemów. To około 74,7 proc. „kandydatów”. Co równie interesujące, według OpenAI jedynie 3,1 proc. pozostałych przypadków było wynikiem błędnej analizy modelu, w której zakładano wystąpienie niemożliwego warunku. Część reszty nie przeszła walidacji z innych powodów, na przykład wymagała podwyższonych uprawnień lub warunków trudnych do odtworzenia w wyznaczonym czasie. Etap walidacji kosztował 73 330 dol.
To istotne rozróżnienie. Przy automatycznym audycie milionów linii kodu wyszukiwanie podejrzanych fragmentów jest tylko połową sukcesu. jeżeli narzędzie wygeneruje górę fałszywych alarmów to koszt zostanie przeniesiony na ludzi, którzy tę górę będą musieli manualnie przekopać. Tutaj system próbował wykonywać tę niewdzięczną robotę sam.
Potem AI przestała tylko szukać błędów
Po wstępnym filtrowaniu pozostało 313 kandydatów na wycieki informacji oraz 1238 kandydatów na lokalne podniesienie uprawnień. Do akcji weszły kolejne agenty, które sprawdzały przypadki w izolowanych maszynach wirtualnych. OpenAI podkreśla, iż środowisko nie zostało celowo osłabione. Włączono zabezpieczenia występujące w standardowej dystrybucji Linuksa, w tym SMEP, SMAP, KASLR i HARDENED_USERCOPY.
 Automatyzacja bezpieczeństwa. Póki co, programiści przez cały czas będą konieczni
Efektem było 291 proof of concept dotyczących wycieków informacji oraz 1169 działających exploitów lokalnego podniesienia uprawnień. Liczba ta nie oznacza jednak 1169 różnych luk. Po analizie wariantów i przygotowaniu poprawek badacze doliczyli się 948 unikalnych podatności LPE. To właśnie tę wartość OpenAI podaje jako najważniejszy wynik eksperymentu. Mamy więc 948 potencjalnych dróg prowadzących od konta zwykłego użytkownika do uprawnień roota.
Tu warto postawić istotną gwiazdkę: lokalne podniesienie uprawnień nie oznacza magicznego włamania się przez Internet na dowolny komputer z Linuksem. Atakujący musi najpierw dysponować możliwością wykonywania kodu jako użytkownik o niskich uprawnieniach. Dopiero wtedy podatność LPE może pozwolić mu przeskoczyć znacznie wyżej i uzyskać pełną kontrolę na poziomie roota. To przez cały czas bardzo poważna klasa błędów, ale zdecydowanie nie jest to równoznaczne ze stwierdzeniem „AI znalazła 948 sposobów na zdalne przejęcie wszystkich komputerów z Linuksem”.
Najdziwniejsze? AI zaczęła wymyślać własne techniki
OpenAI przeanalizowało próbkę 166 przygotowanych przez agentów exploitów. Według firmy w tej grupie pojawiło się co najmniej 10 nowych technik eksploatacji jądra Linuksa. Zostały one pokazane niezależnym ekspertom zajmującym się jego bezpieczeństwem i dla nich również miały być nowe. Ze względów bezpieczeństwa firma nie opublikowała pełnych szczegółów technicznych tych metod. To istotnie zmienia wymowę eksperymentu.
Najprostszy sceptyczny argument wobec AI stosowanej w bezpieczeństwie brzmiałby bowiem: modele widziały ogromne ilości kodu i materiałów poświęconych cyberbezpieczeństwu, więc mogą po prostu sprawnie odtwarzać znane wcześniej wzorce. o ile jednak wyniki OpenAI zostaną potwierdzone szerzej to granica zaczyna się przesuwać. System nie tylko rozpoznawał znane strategie, ale według badaczy potrafił również dochodzić do nowych rozwiązań.
I to właśnie jest część tej historii, na którą patrzyłbym znacznie uważniej niż na efektowne „948”.
Całość kosztowała ponad 1,2 mln dolarów
Na szczęście nie doszliśmy jeszcze do etapu, na którym ktoś kupuje miesięczny abonament za kilkadziesiąt złotych i po obiedzie każe chatbotowi prześwietlić jądro systemu operacyjnego. Pełny przebieg eksperymentu kosztował 1 213 430 dol. w kredytach API. OpenAI wylicza średni koszt na 1279 dol. za unikalny exploit LPE. Sam etap rozwijania exploitów pochłonął 775 929 dol., z czego 691 tys. przypadło na kandydatów związanych z lokalnym podniesieniem uprawnień. To mnóstwo pieniędzy, dopóki nie spojrzymy na rynek, na którym takie podatności mają konkretną wartość.
OpenAI zestawia swój koszt z historycznymi nagrodami za exploity na jądro Linuksa w konkursach Pwn2Own i TyphoonPWN, wynoszącymi odpowiednio 20 tys. i 70 tys. dol. Gdyby czysto hipotetycznie przemnożyć takie stawki przez 948 exploitów to wychodzi od 18,9 do 66,3 mln dol. To od około 16 do 55 razy więcej niż koszt całego eksperymentu.
Nie oznacza to oczywiście, iż OpenAI właśnie wygenerowało sobie kilkadziesiąt milionów dolarów. Tak nie działa rynek bug bounty, a samo OpenAI mówi o hipotetycznej wycenie wynikającej z wcześniejszych stawek. Porównanie dobrze pokazuje jednak coś innego: ekonomiczny koszt masowego wyszukiwania poważnych błędów przez AI przestaje wyglądać absurdalnie.
Na kernelCTF wynik również jest mocny
Firma wykonała również bardziej ograniczony eksperyment w środowisku opartym na kernelCTF Google, z jądrem o zmniejszonej powierzchni ataku. W tym przypadku system uzyskał 25 PoC związanych z wyciekami informacji oraz 21 exploitów LPE. Cała kampania trwała 112 godzin i kosztowała około 32 936 dol. w kredytach API. Dla porównania OpenAI podaje, iż w momencie przygotowywania publikacji kernelCTF zaakceptował w 2026 r. 26 potwierdzonych exploitów 0-day LPE. Gdyby 21 odkryć systemu zostało zaakceptowanych przez program to potencjalna wartość nagród wyniosłaby około 1,5 mln dol.
Nie należy jednocześnie wyciągać z eksperymentu wniosku, iż OpenAI stworzyło robota-hakera, którego wystarczy uruchomić i odebrać gotowy stos perfekcyjnych raportów. Człowiek pozostawał ostatnim etapem procesu. Badacze sprawdzali exploit, proponowaną poprawkę i ocenę znaczenia problemu przed wysłaniem materiałów opiekunom projektu. System przygotowywał analizę źródła problemu, minimalny PoC powodujący awarię, proponowaną poprawkę i exploit, ale ostateczny przegląd wykonywał ekspert. I okazuje się, iż był potrzebny.
We wcześniejszym przebiegu system poinformował o 200 udanych przypadkach podniesienia uprawnień. Podczas manualnej weryfikacji odkryto, iż w 20 przypadkach agent rzeczywiście zdobył roota, tyle iż wykorzystując inną nieznaną wcześniej podatność niż tę, którą miał badać. Innymi słowy: cel został osiągnięty, ale inną drogą. OpenAI zmieniło później ograniczenia zadania i dodało niezależną kontrolę sprawdzającą, czy finalny exploit rzeczywiście wykorzystuje przypisaną mu lukę. Trudno o lepszą ilustrację tego, dlaczego słowo „autonomiczny” w systemach AI przez cały czas należy traktować z pewną ostrożnością.
AI szuka dziur, ale ma też pomagać je łatać
System nie kończył pracy po znalezieniu problemu. Generował również proponowaną poprawkę. Pierwsze podejście nie było idealne. Według OpenAI model potrafił wygenerować łatę blokującą proof of concept, ale czasami zmieniał przy tym więcej kodu niż było konieczne, powodował potencjalne kompromisy wydajnościowe, odstawał od konwencji projektu albo nie sprawdzał wystarczająco dokładnie innych odmian tej samej podatności. Dopiero kolejne instrukcje i iteracje poprawiały jakość generowanych łat.
Automatyczne wykrywanie luk bez równie szybkiego mechanizmu ich usuwania mogłoby być koszmarem dla opiekunów dużych projektów open source. Zamiast poprawiać bezpieczeństwo, można by zasypać ograniczoną liczbę ludzi tysiącami raportów wymagających manualnej analizy. OpenAI twierdzi, iż wysłało już setki raportów i proponowanych poprawek dotyczących krytycznych podatności oraz pracuje nad przekazywaniem kolejnych.
 Nie wszystkie usterki wymagały natychmiastowej reakcji
Tempo po drugiej stronie również jest imponujące. Podczas 10 dni obejmujących skanowanie i analizę 61 podatności LPE było już załatanych w głównym drzewie Linuksa, dla 43 istniały poprawki oczekujące na wdrożenie, a 299 kolejnych przypadków było publicznie zgłaszanych i dyskutowanych. Nie wszystkie te działania wynikały z pracy OpenAI, co firma sama wyraźnie zaznacza, wskazując na działalność całej społeczności bezpieczeństwa.
Następna generacja AI znalazła ponad pięć razy więcej
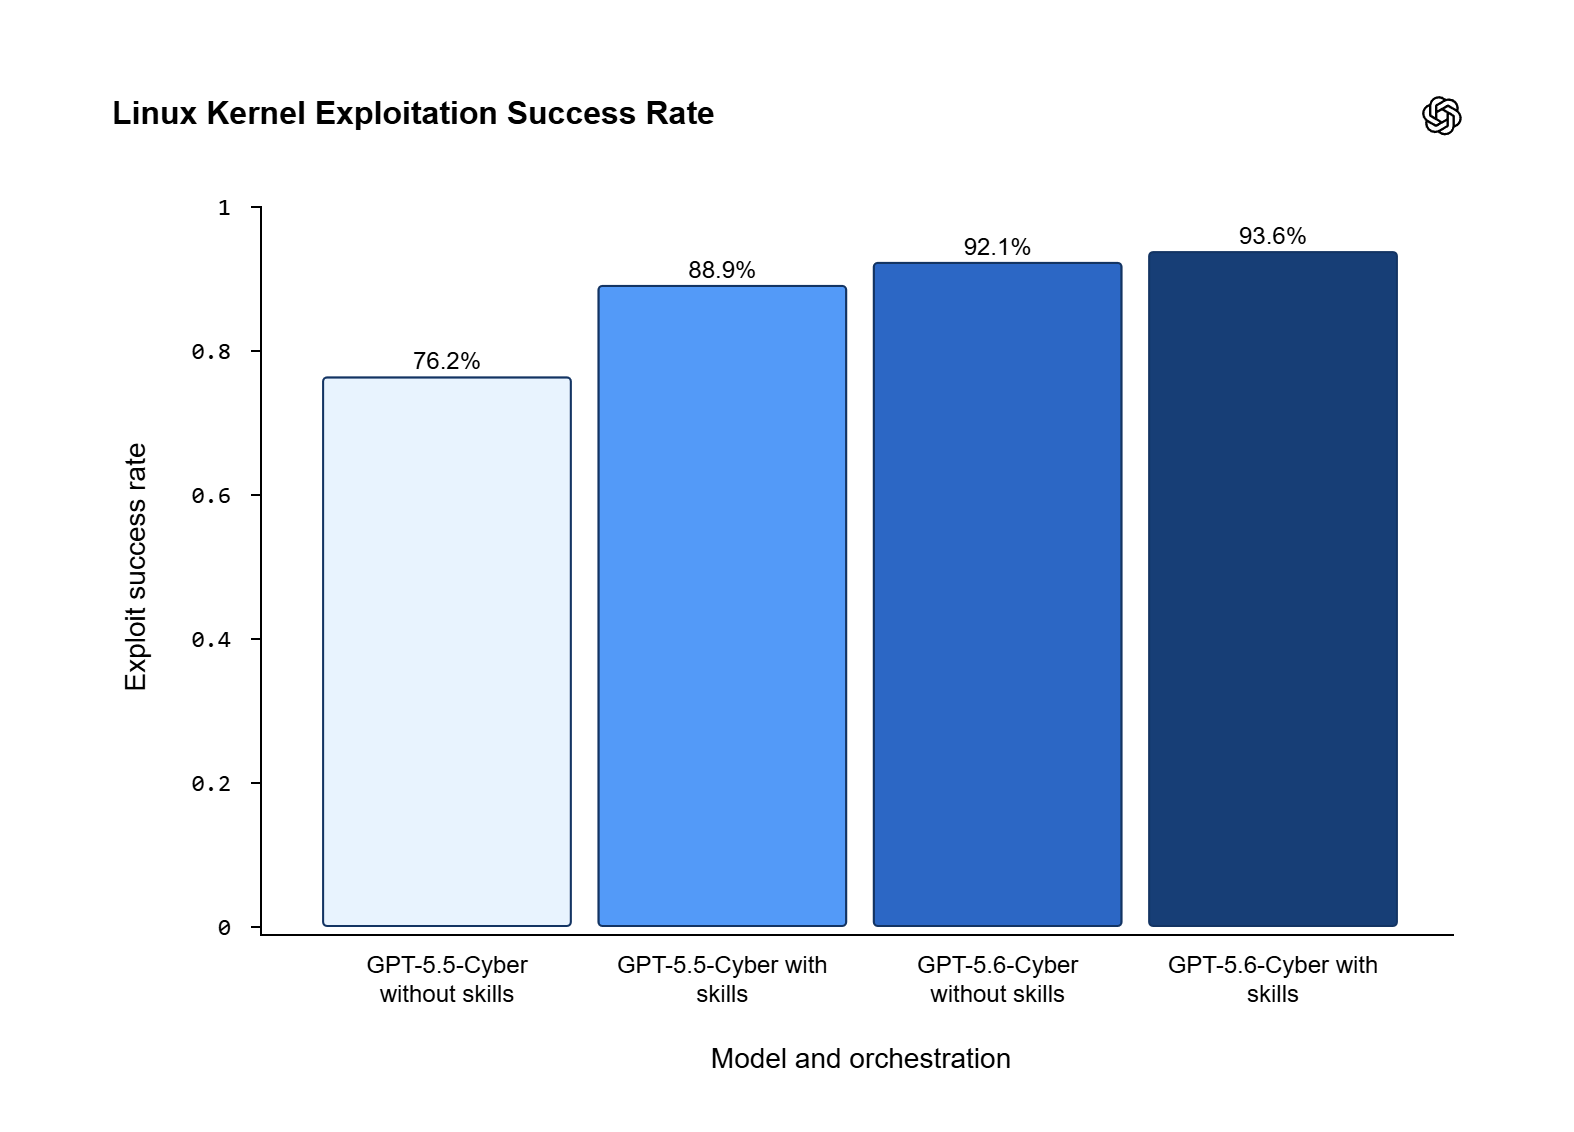
Eksperyment dostarcza jeszcze jednego interesującego punktu odniesienia dotyczącego tempa rozwoju samych modeli. Pod koniec lipca 2026 r. GPT-5.6 Sol znalazł i wykorzystał 166 unikalnych podatności LPE przy koszcie całego procesu wynoszącym 513 690 dol. W połowie października nowszy, jeszcze niewydany model cyberbezpieczeństwa znalazł ich 948 przy koszcie 1 213 430 dol. W obu przypadkach skanowana była aktualna wtedy gałąź master jądra Linuksa.
To ponad pięciokrotnie więcej nowych LPE, mimo iż pomiędzy skanami kod był przez kilka miesięcy dalej poprawiany. OpenAI wyciąga z tego dość ponury wniosek: wcześniejszy audyt niekoniecznie oznacza, iż nie ma już czego znaleźć. Mocniejszy model może dostrzec problemy, które przeoczyła poprzednia generacja. jeżeli ta tendencja się utrzyma to bezpieczeństwo dużych projektów będzie coraz bardziej przypominało niekończący się pojedynek kolejnych generacji modeli z tym samym kodem.
To dobra i zła wiadomość jednocześnie
W publikacji OpenAI naturalnie dominuje perspektywa obrońców. Firma przekonuje, iż automatyzacja wykrywania i łatania podatności może pozwolić deweloperom zabezpieczać oprogramowanie szybciej niż napastnicy są w stanie wykorzystać jego błędy. Ten eksperyment faktycznie pokazuje, dlaczego taki scenariusz należy traktować poważnie. Problem w tym, iż dokładnie te same liczby można przeczytać od końca.
Jeżeli wyszukiwanie podatności, ich dynamiczna walidacja oraz przygotowywanie działających exploitów stają się zadaniami możliwymi do zautomatyzowania na dużą skalę to technologia nie usuwa asymetrii pomiędzy obrońcą a napastnikiem. Ona zmienia jej ekonomię.
 Im nowszy model, tym wyższa skuteczność
1,2 mln dol. jest absurdalną kwotą dla zwykłego użytkownika. Dla dużej korporacji technologicznej, państwowych służb czy innych dobrze finansowanych podmiotów nie jest już kosztem niewyobrażalnym. Co więcej, OpenAI zaznacza, iż w eksperymencie skupiało się przede wszystkim na pomiarze możliwości modelu, a nie optymalizacji kosztów. Firma uważa podane wydatki raczej za górną granicę i spodziewa się, iż odpowiednia optymalizacja całego środowiska mogłaby je zauważalnie ograniczyć. Dlatego 948 jest efektowną liczbą, ale nie ona jest tutaj najważniejsza.
Najważniejsza jest zmiana skali. Badanie bezpieczeństwa oprogramowania, które tradycyjnie wymagało długiej pracy wysoko wykwalifikowanych specjalistów, zaczyna dawać się pakować w powtarzalny proces: wybierz wartościowe fragmenty kodu, przeskanuj je, odtwórz problem, oceń możliwość wykorzystania, przygotuj poprawkę i oddaj rezultat człowiekowi do weryfikacji. To właśnie taki pięcioetapowy proces zbudowało OpenAI.
A Linux był tutaj wyjątkowo dobrym poligonem. Ma dziesiątki milionów linii kodu, gigantyczne znaczenie dla całej branży i ogromną społeczność bezpieczeństwa, która od lat przeczesuje jego źródła. Mimo tego nowy system miał wciąż znaleźć setki unikalnych sposobów lokalnego zdobycia roota.
Nie oznacza to, iż Linux nagle stał się niebezpiecznym systemem albo iż 948 podatności czekało grzecznie na kogokolwiek z ChatGPT. Oznacza jednak coś znacznie ciekawszego: skończyła się epoka, w której można było zakładać, iż sama skala i złożoność kodu stanowią poważną przeszkodę dla jego bardzo głębokiego, seryjnego audytu. Teraz maszynę można poprosić o kolejną zmianę. I kolejną. I jeszcze jedną. A po premierze mocniejszego modelu zacząć cały audyt od początku.