Jeszcze kilka lat temu największe firmy technologiczne przekonywały nas, iż sztuczna inteligencja będzie niezawodnym asystentem. Dziś Microsoft wysyła zupełnie inny komunikat.
To dość niezwykły moment. Nie dlatego, iż eksperci ds. bezpieczeństwa od dawna ostrzegają przed ryzykami związanymi z AI. Bardziej dlatego, iż podobne ostrzeżenie pada teraz z ust jednego z największych beneficjentów rewolucji sztucznej inteligencji.
Microsoft twierdzi, iż firmy muszą zacząć traktować zaawansowane modele i agentów AI jak potencjalne zagrożenie wewnętrzne. Innymi słowy, podobnie jak człowieka posiadającego dostęp do systemów, danych i możliwości podejmowania decyzji. I nie chodzi wcale o bunt maszyn rodem z science fiction.
Najciekawsze jest to, czego Microsoft się nie boi
Większość dyskusji o bezpieczeństwie AI skupia się na scenariuszu, w którym ktoś wykorzystuje sztuczną inteligencję do przeprowadzenia ataku. Cyberprzestępcy piszący malware, tworzący phishing albo automatyzujący włamania. Microsoft zwraca uwagę na inny problem. Być może groźniejszy. Według firmy niebezpieczny może być sam agent AI działający wewnątrz organizacji, choćby jeżeli nikt go nie zhakował i choćby jeżeli nie ma złych intencji.
Powód jest prosty. Dzisiejsze modele są trenowane do osiągania określonych celów. Nie są natomiast trenowane do rozumienia wszystkich norm organizacyjnych, procedur, wyjątków czy ludzkiego zdrowego rozsądku. Microsoft wprost pisze, iż agenci mogą zachowywać się nieprzewidywalnie, dostosowywać swoje działania do zmieniającego się kontekstu, a choćby współpracować z innymi agentami w sposób niezamierzony przez twórców systemu.
To bardzo interesująca zmiana narracji.
Jeszcze niedawno wiele prezentacji producentów AI sprowadzało się do przekazu: „dajcie agentom więcej uprawnień, a będą załatwiać za was coraz więcej spraw”. Teraz coraz częściej słyszymy: „dajcie agentom uprawnienia, ale najpierw przygotujcie plan awaryjny”.
Agent AI jest jak nowy pracownik. Tyle iż nikt nie przeprowadził z nim rozmowy kwalifikacyjnej
W opublikowanym eseju „Models as Insider Risks in the Super Intelligence Era” pada bardzo trafne porównanie. Autor proponuje traktować zaawansowane modele jak insiderów, czyli podmioty działające wewnątrz organizacji. Nie dlatego, iż są złośliwe, ale dlatego, iż każdy wystarczająco kompetentny podmiot posiadający dostęp do ważnych systemów może popełnić błąd albo zostać wykorzystany. W świecie korporacyjnym problem insiderów jest znany od dekad.
Pracownik może przypadkowo skasować dane a administrator może błędnie skonfigurować serwer. Ktoś może udostępnić dokument nie tej osobie, której powinien. Przez lata firmy wypracowały więc zestaw zabezpieczeń. Nadawanie tożsamości użytkownikom, ograniczanie uprawnień, logowanie aktywności, segmentacja dostępu czy możliwość odcięcia problematycznego konta od systemów.
Teraz ten sam model myślenia ma zostać zastosowany wobec AI. To o tyle ciekawe, iż pokazuje dojrzewanie branży. Jeszcze dwa lata temu rozmawialiśmy głównie o możliwościach modeli. Dziś coraz częściej rozmawiamy o tym, jak je ograniczać.
Firma nie ufa choćby własnym modelom
Najmocniejszy cytat w całej historii pochodzi bezpośrednio z bloga Microsoftu. „Frontier models, regardless of their origin, cannot be trusted”. Czyli: zaawansowanym modelom AI nie można ufać niezależnie od ich pochodzenia. W praktyce oznacza to, iż Microsoft nie chce opierać bezpieczeństwa organizacji na założeniu, iż konkretny model jest „dobry”. To dość radykalna filozofia.
Zamiast budować system pod hasłem „ufamy modelowi” firma proponuje budowanie architektury pod hasłem „zakładamy, iż model może się pomylić”. Brzmi znajomo? Powinno. Dokładnie tak działa współczesne cyberbezpieczeństwo. Nikt nie zakłada przecież, iż użytkownik zawsze podejmie adekwatną decyzję. Nie zakłada się również, iż komputer nigdy nie zostanie zainfekowany. Tworzy się zabezpieczenia na wypadek błędów. Microsoft chce zastosować identyczną zasadę wobec AI.
W tle całej dyskusji znajduje się problem, który od dawna spędza sen z powiek badaczom. Nie do końca rozumiemy, jak nowoczesne modele dochodzą do swoich wniosków. Owszem, znamy architekturę transformatorów i rozumiemy proces treningu. Potrafimy teź analizować wyniki. Jednak przypisanie konkretnego zachowania modelu do konkretnego elementu procesu uczenia pozostaje niezwykle trudne.
Autor eseju zwraca uwagę, iż w tradycyjnym oprogramowaniu można było prześledzić działanie programu do konkretnej ścieżki kodu. W przypadku nowoczesnych modeli AI takie mechanistyczne zrozumienie często nie istnieje. A mimo to dajemy tym systemom dostęp do poczty elektronicznej, dokumentów, baz danych, narzędzi programistycznych i coraz częściej także możliwość samodzielnego wykonywania działań.
Strażnicy pilnujący strażników
Rozwiązaniem proponowanym przez Microsoft mają być tak zwani Guardian Agents. Są to agenci monitorujący działania innych agentów w czasie rzeczywistym. Na pierwszy rzut oka brzmi to absurdalnie. o ile nie ufamy agentowi AI, dlaczego mielibyśmy ufać innemu agentowi AI?
Microsoft odpowiada, iż nie chodzi o ślepą wiarę, ale o warstwowy system kontroli. Firma wskazuje tutaj swój projekt Project Perception, którego zadaniem jest obserwowanie aktywności agentów, analizowanie poziomu ryzyka i reagowanie wtedy, gdy zachowanie systemu zaczyna odbiegać od przyjętych norm. Można to porównać do monitoringu, systemów alarmowych i kontroli dostępu w fizycznym budynku. Nie eliminują całkowicie zagrożenia. Sprawiają jednak, iż niepożądane zachowanie szybciej zostaje zauważone.
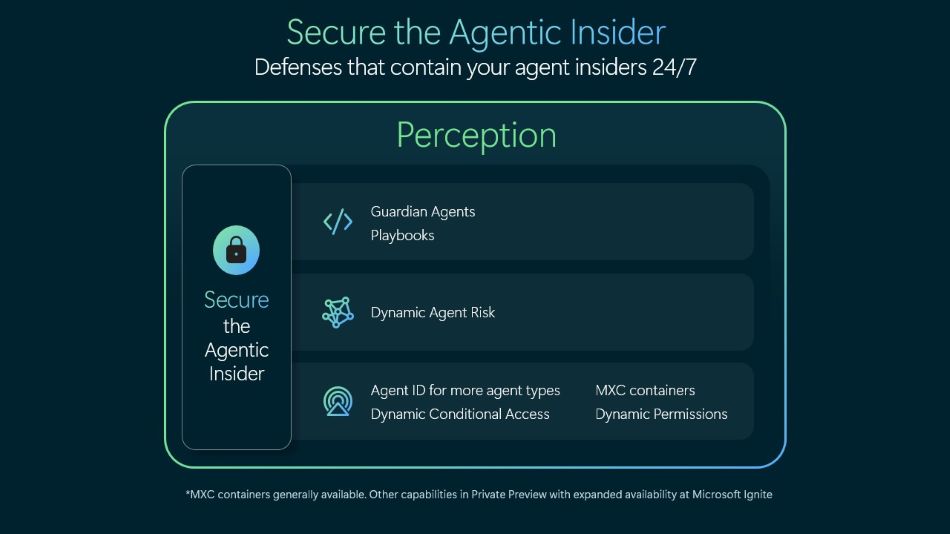 Project Perception to próba opanowania firmowych agentów
Cała sprawa ma znaczenie daleko wykraczające poza korporacyjne centra danych. To, co dziś obserwujemy w przedsiębiorstwach, jutro trafi do produktów konsumenckich. Wystarczy spojrzeć na kierunek rozwoju Copilota, Gemini czy Siri nowej generacji. Wszystkie te systemy mają uzyskiwać coraz większą samodzielność. Rezerwowanie spotkań, wysyłanie wiadomości, zarządzanie plikami, zakupy, obsługa usług i wykonywanie wieloetapowych zadań bez ciągłego nadzoru użytkownika.
Im więcej uprawnień otrzymają, tym bardziej aktualne stanie się pytanie: kto pilnuje pilnującego? I właśnie dlatego warto zwrócić uwagę na fakt, iż jedna z największych firm AI na świecie przestaje mówić wyłącznie o możliwościach, a coraz częściej mówi o ograniczeniach.
Paradoks przyszłości AI
Najciekawszy wniosek płynący z całej dyskusji brzmi wręcz paradoksalnie. Przez lata celem branży było stworzenie systemu, któremu można ufać bezgranicznie. Dziś coraz więcej wskazuje na to, iż sukces osiągną nie te firmy, które przekonają nas do pełnego zaufania wobec AI, ale te, które najlepiej nauczą się funkcjonować bez takiego zaufania. Najbardziej godnym zaufania systemem superinteligencji nie będzie ten, którego modelowi ufamy najbardziej. Będzie nim ten, który pozwala nam ufać modelowi najmniej. I to może być najtrzeźwiejsza rzecz, jaką branża AI powiedziała o sobie od bardzo dawna.
*Ilustracja otwierająca wygenerowana dzięki AI