Do sieci trafiło 11 nowych wariantów polskiego modelu językowego PLLuM. To otwarty system AI stworzony po to, by radzić sobie z polskim prawem, dokumentami i procedurami. Modele potrafią napisać pismo w 20 urzędowych formatach i przełożyć skomplikowany prawniczy żargon na zrozumiałe zdania. Każdy może je pobrać i zintegrować z własnym biznesem bez opłat.
Głównym zadaniem modeli PLLuM jest bieżąca praca z urzędową polszczyzną, na której często gubią się zagraniczne algorytmy. System nie tylko generuje gotowe teksty administracyjne, ale też potrafi pracować na wzorach umów prawnych, streszczać je i upraszczać ich język. Z modelu już teraz korzysta administracja państwowa. Oprogramowanie wspiera obsługę spraw i rozmowy w aplikacji mObywatel. Najnowsza paczka modeli opiera się na analizie rzeczywistych interakcji z użytkownikami, dzięki czemu system ma rzadziej się mylić i udzielać bezpieczniejszych, bardziej logicznych odpowiedzi.
Co dokładnie udostępniono i co to daje?
W ramach nowej puli udostępniono 11 wariantów, które różnią się zapotrzebowaniem na zasoby. Umożliwia to instytucjom i firmom dobór wersji do posiadanej infrastruktury serwerowej. Najmniejsza wersja, oznaczona jako 4B, została przystosowana do pracy przy ograniczonej mocy obliczeniowej, jednak wymaga wcześniejszego dostosowania do konkretnego zadania.
Modele 8B i 12B to warianty o średnich wymaganiach sprzętowych, przeznaczone głównie do wdrożeń w przedsiębiorstwach. Wykorzystuje się je między innymi w systemach RAG, służących do przeszukiwania i analizowania wewnętrznych baz danych. Z kolei największy udostępniony model, 70B, zaprojektowano do realizacji złożonych operacji tekstowych bez konieczności jego dodatkowego douczania.
Mniejsze warianty wydano w wersjach bazowych (surowych), instrukcyjnych (do konkretnych poleceń) oraz dialogowych (do rozmowy, z filtrami blokującymi szkodliwe treści). Największy model, 70B, jest dostępny w wersji instrukcyjnej i dialogowej.
Skąd AI czerpie wiedzę?
Projekt zrealizowało konsorcjum HIVE pod kierownictwem instytutu badawczego NASK. W przeciwieństwie do zamkniętych systemów komercyjnych, baza wiedzy PLLuM jest w pełni jawna, udokumentowana i jak podaje Ministerstwo Cyfryzacji, zgodna z unijnymi przepisami AI Act.
Do treningu AI użyto 7 milionów polskich tekstów. Dane nie były przypadkowe. Pochodziły z domeny publicznej, w tym z Dziennika Ustaw, Monitora Polskiego, sejmowych stenogramów oraz zasobów na darmowych licencjach. Dodatkowo na etapie douczania wdrożono 80 tysięcy manualnie przygotowanych instrukcji i dialogów, aby wymusić na modelach naturalny sposób prowadzenia rozmowy.
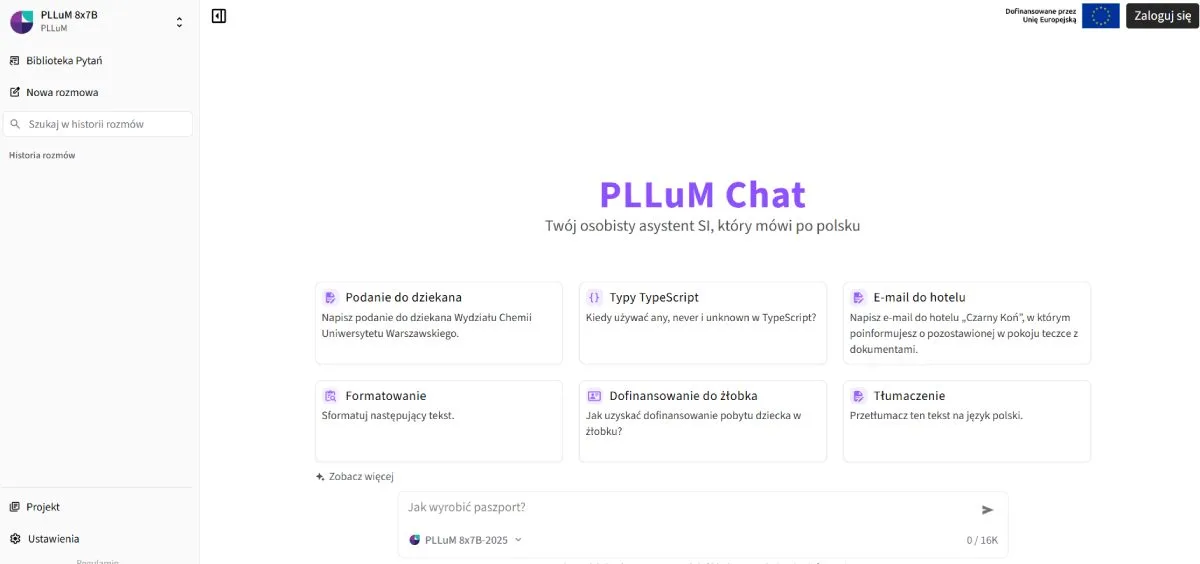
Wszystkie nowe warianty PLLuM opublikowano na całkowicie otwartych licencjach. Pliki z modelami można pobrać z platformy Huggingface, a osoby chcące wyłącznie sprawdzić, jak system odpowiada na pytania, mogą skorzystać z darmowego czatu graficznego w przeglądarce.
Źródło tekstu i zdjęcia otwierającego: PLLuM