Claude Code w embedded pół roku później: co się zestarzało, a co nie
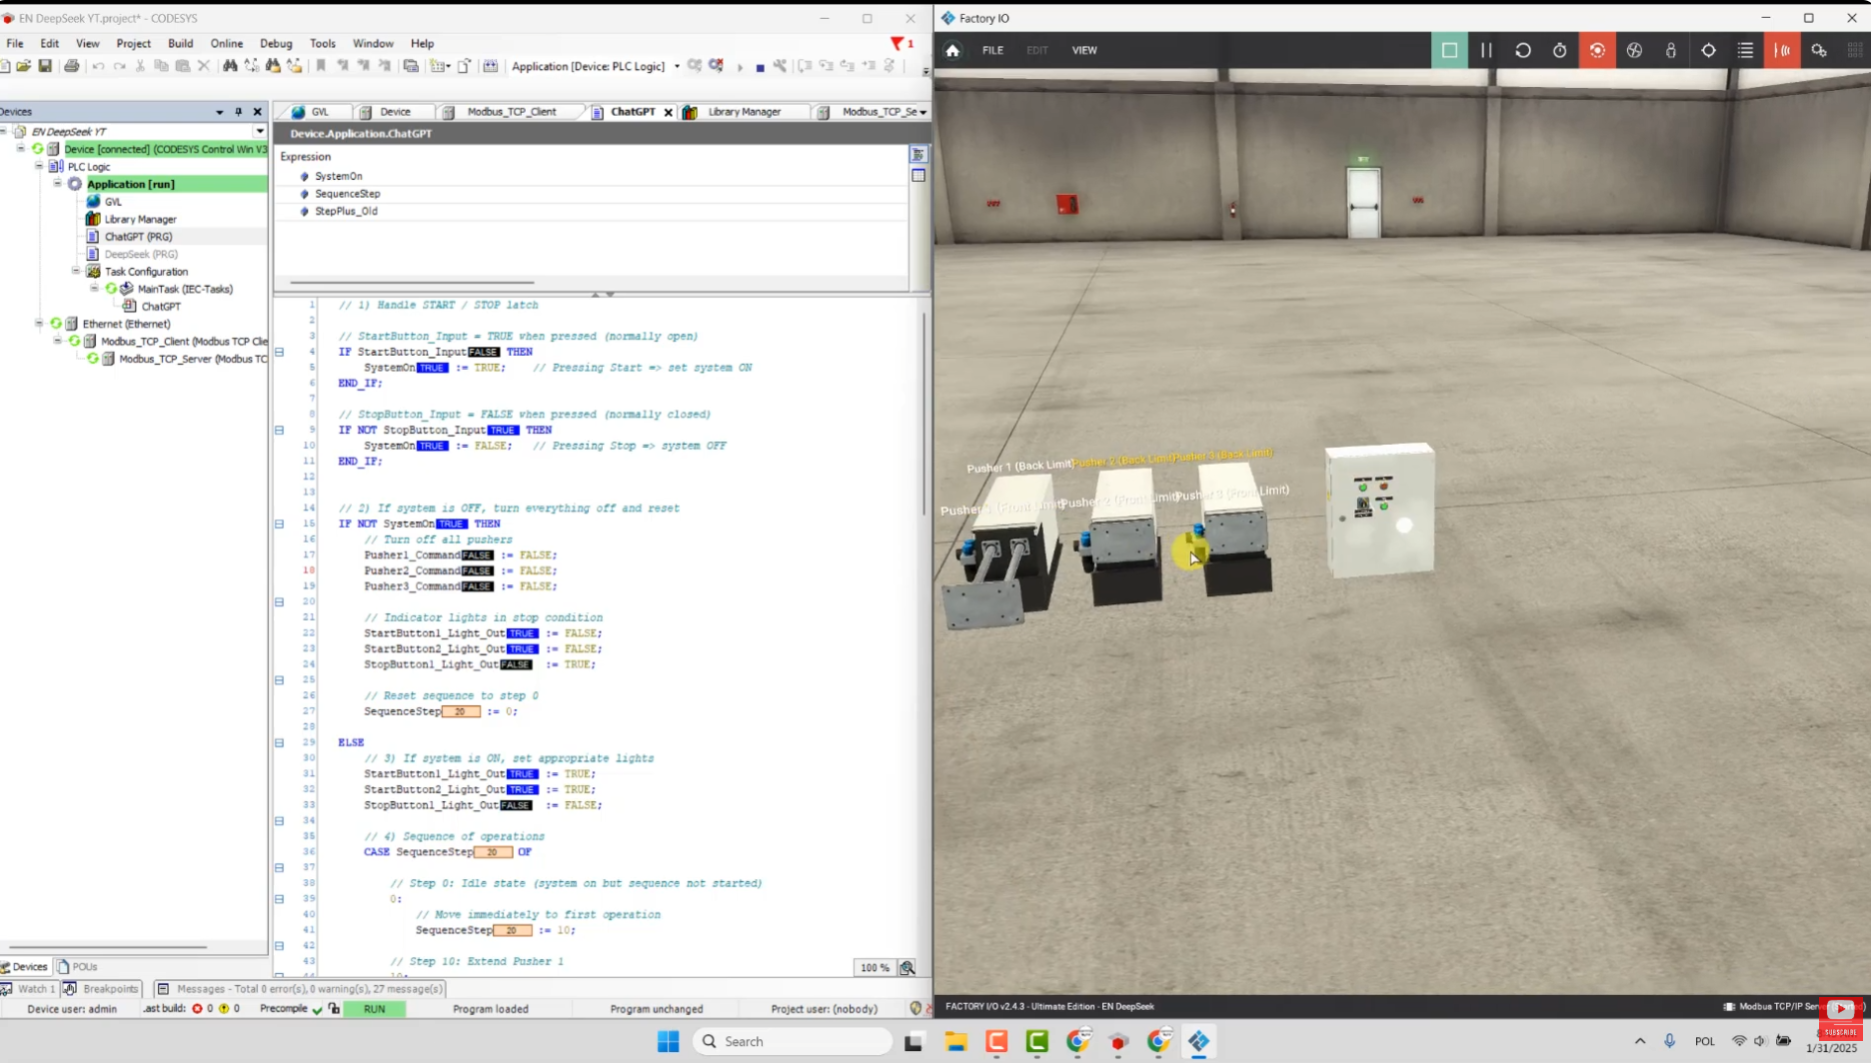
W kwietniu sprawdziłem na żywo Claude Code w embedded: posadziłem go razem z Codexem przed nową płytką NUCLEO-C562RE, dałem im czujnik BMP280, świeżego HAL2 i ogólne polecenia. Claude Code stanął na limicie w połowie roboty. Codex dokończył najprostszą wersję i po dwóch godzinach temperatura z ciśnieniem leciały na terminal, ale on też zjadł prawie cały limit. Opisałem to w majowym artykule i zakończyłem zdaniem, iż AI to świetny wspomagacz, ale jeszcze nie zastępca.
Od tamtego live’a minęło ponad pięć miesięcy. Dzisiaj tamten tekst jest w połowie nieaktualny. I o tym jest ten artykuł: stwierdzenia o AI dezaktualizują się szybciej niż cokolwiek, co znam z embedded. Moje również.
To nie było moje pierwsze podejście
Zacznę od tego, bo część osób traktuje tamten live jak mój pierwszy kontakt z AI. To, co widać publicznie, to nie wszystko.
Z AI pracuję od dawna, także przy programowaniu. STM32 i inne mikrokontrolery programuję z jego pomocą już bardzo długo. W marcu 2025 wystąpiłem na meetupie z prezentacją „Jak AI pozwala mi programować rzeczy, o których nie mam żadnego pojęcia”. I wtedy naprawdę nie podobało mi się do końca to, w jaki sposób GPT czy Claude radziły sobie z embedded w wersji czatowej.
Dosłownie wtedy, kiedy robiłem tę prezentację, ogłoszono Claude Code. Był nowinką, a dzisiaj, według moich obserwacji, jest najważniejszym agentem AI!
Moje stwierdzenia, iż LLM-y średnio radzą sobie z embedded, nie były wyssane z palca. Nie brały się też ze strachu o sprzedaż kursów programowania (bo przecież najłatwiej mi to zarzucić ;)). Brały się z praktyki i doświadczenia w programowaniu.
Na kwietniowym live nie byłem więc sceptykiem, który szuka dowodu. Założenie było proste: pełna dowolność dla agenta i minimalistyczny prompt pisany na kolanie. Totalna samowolka, bez żadnego nakierowania. Chciałem zobaczyć, czy agent rzeczywiście zrobi robotę za mnie, tak jak pisali komentujący pod moimi reklamami.
Z czatem pracowałem od dawna, ale w agentach dopiero zaczynałem i mówiłem to na live wprost. Kto wykorzystuje dziś moje słowa z tamtego live’a, ten chyba nie oglądał go uważnie
I zmartwiło mnie to, co z tej samowolki wyszło. Agent, który nie dostał projektu, tylko jedno polecenie, robił to, co mu się wydawało.
Co się zestarzało: modele i koszt
Od modelu, na którym wtedy pracowałem, Anthropic wydał cztery kolejne Opusy: 4.7 jeszcze w kwietniu, 4.8 w maju, Opus 5 w lipcu i Opus 5.5 we wrześniu. Po drugiej stronie GPT-6 Sol pojawił się 22 września, a 29 września zastąpił go 6.1 Sol. Model żył tylko tydzień! Jak tu coś nagrywać o AI, jak to się tak gwałtownie zmienia?
Anthropic i OpenAI naprawdę mocno walczą o dominację. Wypuszczają coraz nowsze modele w coraz krótszych odstępach, a postęp ich możliwości jest wykładniczy. Mierzy to METR, niezależna organizacja badająca, co modele potrafią zrobić samodzielnie. Sprawdza, jak długie zadanie programistyczne model doprowadza do końca w połowie prób, a długość liczy czasem, jakiego potrzebowałby na nie doświadczony człowiek. Według jej styczniowych pomiarów ta długość podwaja się mniej więcej co cztery miesiące.
Ludzki mózg słabo ogarnia taki postęp. Myślimy liniowo: skoro pół roku temu było słabo, to dziś jest trochę mniej słabo. A nie jest.
Dlatego nie powtarzam tamtego eksperymentu. Wynik byłby nieaktualny, zanim zdążyłbym go opisać. To bez sensu.
Kilka liczb, wszystkie ze stanu na 2 października 2026:
- Opus 5.5 kosztuje w API 4 i 20 dolarów za milion tokenów. Wszystkie poprzednie od 4.6 kosztowały 5 i 25. Jest ciut taniej.
- Przy premierze 5.5 Anthropic podniósł limity 5-godzinne w planach i podał, iż typowe zadanie wychodzi około 40% taniej niż na Opusie 5. Regularnie dostajemy więcej za mniej.
- Niezależne Artificial Analysis zmierzyło, iż na maksymalnym efforcie Opus 5.5 zużywa 1,6 raza więcej tokenów wyjściowych na zadanie niż Opus 5, więc koszt zadania wychodzi podobny.
Dwie liczby o koszcie pochodzą z tego samego tygodnia i mówią co innego, bo dotyczą innych ustawień. Maksymalny effort to nie jest tryb do codziennej pracy, a ja w kwietniu właśnie tak pracowałem: Opus 4.6 na xhigh.
Ja sam nie śledzę wszystkich nowinek i nie mam zamiaru. Dlatego uprościłem sobie wybór modelu: korzystam z najnowszego, na domyślnym efforcie. Do konkretnego zadania przestawiam go najwyżej o jedno oczko w górę albo w dół. Tyle.
Co to znaczy dla programowania: Terminal-Bench
Sama cena kilka mówi, więc jeden test opiszę dokładniej.
Terminal-Bench to otwarty test rozwijany przez społeczność i zespół Harbor. Agent dostaje terminal w kontenerze i zadanie do wykonania od początku do końca: skompilować, skonfigurować, naprawić, uruchomić. Nie pisze pojedynczej funkcji, tylko ma dowieźć działający efekt. Kiedy skończy, osobny skrypt sprawdza stan końcowy. Zadanie jest zaliczone tylko wtedy, gdy przechodzą wszystkie testy. Punktów cząstkowych nie ma.
Kiedy robiłem live, obowiązywała wersja 2.0 z 89 zadaniami. Według wyników podawanych przez Anthropic Opus 4.6 miał w niej około 65%, a wydany tuż przed live’em Opus 4.7 około 69% (zestawienie). W poprawionej wersji 2.1 Opus 4.8 doszedł w maju do 79%, a GPT-5.5 do 83% (tabela wyników).
Test przestał cokolwiek rozróżniać, więc powstała wersja 4.0: 66 zupełnie nowych zadań z programowania, nauki, uczenia maszynowego, sprzętu i bezpieczeństwa. Połowa z nich to dla eksperta co najmniej cztery godziny pracy, najdłuższe 60 godzin. Agent ma na każde osiem godzin.
W niezależnym pomiarze Vals AI, gdzie każdy model dostaje tego samego prostego agenta z samym terminalem, wyniki w wersji 4.0 są takie:
- Opus 4.8 (maj): 23%
- Opus 5 (lipiec): 54%
- Opus 5.5 (wrzesień): 65%
Starszych Opusów w tej wersji nikt już nie mierzył. Anthropic u siebie podaje dla dwóch ostatnich 52% i 66%.
Co z tego wynika:
- Ten test nie sprawdza, czy model umie napisać funkcję. Sprawdza, czy sam dowiezie kilkugodzinne zadanie do stanu „działa”. Model z maja robił to w co czwartym przypadku. Model z września w dwóch na trzy.
- Skok z 23% na 65% zajął cztery miesiące. To jest ten wykładniczy postęp, którego nie czujemy.
- Co trzecie zadanie dalej kończy się porażką, a agent nie zawsze o tym wie. Ktoś musi umieć rozpoznać, które to było.
- To nie jest embedded. Na 66 zadań pięć dotyczy sprzętu i są to modele CAD oraz projekty RTL. Firmware’u na mikrokontroler tam nie ma. Kontener nie ma płytki, czujnika ani oscyloskopu.
Benchmarków dla embedded dalej więc nie ma. Sam Anthropic pisze zresztą, iż przy tym poziomie różnice w testach coraz słabiej oddają różnice w prawdziwej pracy.
A jak to wygląda u mnie? Plan Pro przestał mi wystarczać, bo po prostu zacząłem dużo pracować z agentami. Przeszedłem na Max 5x i to jest naprawdę spory plan. Tygodniowy limit zużyłem do tej pory raz. Pięciogodzinny wyczerpuję rzadko. Zdanie „plan to godzina pracy” jest dzisiaj nieprawdziwe, ale wierzę, iż przez cały czas da się wyczerpać ten limit w godzinę.
Co się nie zestarzało
Agent wypełnia luki domysłami. Na live Claude uznał pin za wyjście po samej nazwie zmiennej. Zdarzało mi się też dostać rejestry DMA z innego STM32. Od jakiegoś czasu tego problemu nie widzę, ale daleki jestem od stwierdzenia, iż już go nie ma. Od tamtego czasu też dostarczam lepszą dokumentację wejściową, zanim postawimy choć jedną linijkę kodu.
Przyczyna była za każdym razem ta sama: niepełny zestaw danych. jeżeli agent nie wie, na jakim układzie pracuje, to jakiś sobie wymyśli. Nie liczę więc na to, iż kolejny model przestanie zgadywać. Wolę nie dawać mu powodu.
Nie zmieniło się też to, iż trzeba się znać. O tym na końcu.
Dobry input to cała robota
Po tamtym live zacząłem szukać odpowiadającej mi metody pracy, która da zadowalające rezultaty. Po kilku miesiącach efekty są o niebo lepsze i nie zawdzięczam tego głównie nowym modelom.
Input jest królem. To on ma największy wpływ na to, jak projekt zostanie zaplanowany i napisany. Najwięcej czasu spędzam więc na wstępnym opracowaniu projektu, zanim powstanie pierwsza linijka kodu:
- funkcjonalność,
- komponenty,
- wstępna architektura,
- frameworki i biblioteki,
- dokumentacje do komponentów.
Jedno podejście nie wystarcza. Warto zrobić kilka iteracji: tworzymy plan, potem go recenzujemy i poprawiamy. Plan dobrze przerzucić między dwoma modelami od różnych dostawców, np. OpenAI i Claude, albo choćby między słabszym i mocniejszym Claude’em.
Ważne jest jedno: recenzja zawsze idzie w nowej sesji. Model, który plan napisał, ma w kontekście cały tor myślenia, który go do tego planu doprowadził, i będzie go bronił. Świeża sesja widzi tylko plan.
Kilka tygodni temu wystrzelałem cały Claude na 3 dni przed resetem, przeskoczyłem na GPT-5.6 Sol i ten zupełnie inaczej podchodzi do pisania i researchu. Ich uzupełnianie się bardzo mi się podoba, ale często z lenistwa siedzę tylko na Claude Przeskakuję między Sonnet i Opus w zależności od tego, co mają zrobić.
To jest też powód, dla którego praca agentowa zmienia tak dużo względem czatu. Agent siedzi w repozytorium, czyta projekt, sam kompiluje. Można mu przygotować projekt, a nie tylko zadać pytanie.
Z całości robię obszerną dokumentację. Nooo nie ja – agent Pliki md to podstawa. Nie tylko opis projektu, ale również dostarczam to, w jaki sposób ma pisać. Stylistycznie chociażby. Tego uczę go na moich starszych projektach. Jak nie masz projektów, to po prostu polegaj początkowo na jego intuicji.
Dokumentujemy również wdrożenie ficzerów. Nie piszemy na pałę, tylko jest plan funkcji, plan realizacji, plan testów i warunki zamknięcia implementacji. Wszystko robię w tym samym repozytorium.
Nad projektem u mnie aktualnie działa więcej niż 1 agent, a w zasadzie to obsadzam repozytorium różnymi rolami. Repozytorium oczywiście jest zapisywane z użyciem gita, aby był porządek.
Mój poligon testowy – moja firma
W firmie prowadzę tak zwany Second Brain, czyli notatnik z wiedzą o tym, co chcemy osiągnąć i jakie mamy założenia – tak w dużym skrócie. Z niego wychodzą wszystkie projekty. Buduję na przykład aplikację analityczną. Pisze ją kilku agentów równolegle, a kolejny recenzuje ich pracę w pętli. Do systemu ERP, który nie miał żadnego API, powstało i API i nasz własny serwer MCP.
Mój zespół (ten ludzki, a nie AI) pisze własne skille dopasowane do tego, czego faktycznie potrzebują w pracy. Raz na ~3 tygodnie siadamy sobie wspólnie i uczymy się AI. Przekazujemy sobie wiedzę z tego jak się nim wspomagamy.
W embedded agent uczy się mojego stylu kodu z mojego własnego repozytorium i pisze tak jak ja. Sprawdzam też, jak dobrze poprowadzić kilku agentów na STM32, kiedy na biurku leży tylko jedna płytka. A teraz sprawdzam coś, o czym napiszę osobno: agenta, który sam zagląda do płytki, przez GDB i przez kamerę.
Żadna z tych rzeczy nie działała od pierwszego dnia. Każda wymagała tygodni poprawiania. Nie zliczę, ile razy chciałem się poddać, bo AI nie robiło wszystkiego tak, jakbym chciał. Dziś robi to dużo lepiej i chcę również Ciebie nauczyć, jak do tego dojść.
Temat AI strasznie polaryzuje w Internecie
W ostatnim czasie podnoszę temat AI i dzielę się swoimi obserwacjami, tym co robię i komentuję ten świat AI pod kątem embedded.
Wiem, iż różni „internetowi znawcy AI” prowadzą dziś kampanie marketingowe na tym, co skomentowałem wiele miesięcy temu. Że coś było słabe. Tak, wtedy to było słabe.
Uważajcie tylko, bo Wasze dzisiejsze porady, metody i testy za pół roku też będą słabe. I wtedy to ja będę mógł robić kampanie na Waszych nieaktualnych stwierdzeniach
Senior dla turbo-juniora
Jedno twierdzę niezmiennie: żeby dobrze wykorzystać AI i agentów w programowaniu (zwłaszcza profesjonalnym), trzeba się na tym programowaniu znać.
Owszem, efekty będą także bez tego. Ale pełnię możliwości i wsparcia dostaje ten, kto jest seniorem dla swojego turbo-juniora. Kto wie, jaki układ ma na płytce, zauważy, iż agent właśnie wymyślił inny.
Modele zmienią się jeszcze kilka razy, zanim ten tekst się zestarzeje. Liczby z tego artykułu też. Metoda zostanie: dobry input, plan sprawdzony w świeżej sesji i człowiek, który wie, co czyta.
Wiem też, rozmawiając z moimi wspaniałymi kursantami, iż przez cały czas jest ochota na samodzielne zdobywanie wiedzy. Cieszy mnie to, iż wiele osób przez cały czas chce coś potrafić samodzielnie. Bez własnej wiedzy nie zweryfikujemy tego, co robimy z AI. Nie sprawdzimy technicznych niuansów, a koniec końców to człowiek ponosi całą odpowiedzialność.
Chcesz zobaczyć, jak to robię?
Zbieram to w serii maili. Po zapisie dostaniesz:
- Mój setup, który sprawdza mi się na dzisiaj
- Jak nauczyć agenta pisać tak jak Ty?
- Dobry input to cała robota
- AI Software House — pięciu agentów, jeden projekt
Zapisy: https://aiwembedded.pl
Chcesz uczyć się ode mnie pracy z agentem w embedded oraz być na bieżąco? Planuję pewien projekt. Lista mailowa dowie się o nim pierwsza